Kilas Berita: Google's New TPU Lineup, Meta Ember, & Claude Fable 5.2?
1. Google Rilis Lini TPU 8i Max dan 8tx untuk Era Agentic
Sorotan Berita:
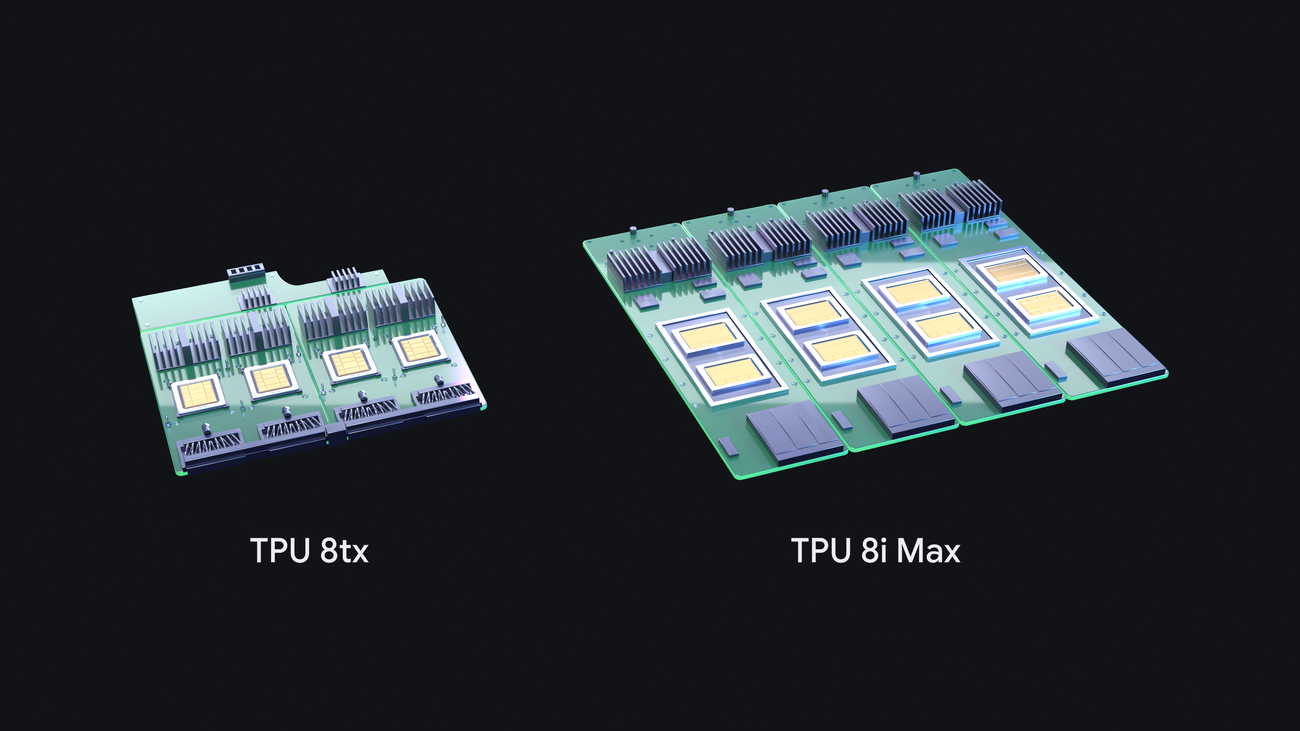
Google baru saja memperkenalkan evolusi terbaru dari infrastruktur AI mereka melalui peluncuran TPU 8i Max dan TPU 8tx. Langkah ini menandai pergeseran fokus Google ke arah "Agentic Era," di mana model AI tidak hanya sekadar menjawab pertanyaan tetapi menjalankan tugas kompleks secara otonom. TPU 8i Max dirancang khusus untuk menangani massive context windows dan densitas komputasi yang lebih tinggi, sementara TPU 8tx hadir sebagai solusi untuk confidential inference, memastikan data sensitif tetap aman selama proses pemrosesan AI di cloud.
- TPU 8i Max: Dioptimalkan untuk model dengan context window raksasa, memungkinkan agen AI memproses ribuan dokumen atau basis kode besar sekaligus dengan latensi rendah.
- TPU 8tx: Fokus pada security dan privacy, mendukung confidential computing yang memungkinkan perusahaan menjalankan model AI pada data terenkripsi tanpa membukanya ke penyedia cloud.
- Compute Density: Peningkatan signifikan pada efisiensi energi dan performa per watt dibandingkan generasi sebelumnya, krusial untuk skalabilitas enterprise AI.
Analisis DO-AI:
Dari perspektif arsitektur, Google sedang membangun moat di level hardware dengan memisahkan beban kerja antara kapasitas konteks (8i Max) dan keamanan data (8tx). Bagi tim engineering, kehadiran TPU 8tx adalah game changer untuk industri yang teregulasi ketat seperti fintech atau healthcare, karena hambatan utama adopsi LLM—yaitu privasi data saat inference—kini memiliki solusi hardware-native. Strategi ini menunjukkan bahwa masa depan AI bukan lagi soal model yang lebih besar, melainkan infrastruktur yang lebih spesifik untuk tugas-tugas otonom.
2. Meta Muse Ember: Model Reasoning Kecil yang Mengalahkan Efisiensi GPT-6 Luna
Sorotan Berita:
Meta secara mengejutkan merilis Muse Ember, sebuah small reasoning model yang dirancang khusus untuk efisiensi ekstrem dalam tugas-tugas agen AI. Meskipun ukurannya ringkas, Muse Ember diklaim mampu menyamai skor reasoning tertinggi dari Claude Haiku 5.5 dengan biaya hanya sepertiganya. Lebih impresif lagi, model ini mengungguli GPT-6 Luna dalam berbagai skenario penalaran, menjadikannya pemimpin baru di efficiency frontier pada leaderboard Artificial Analysis. Fokus utama model ini adalah eksekusi tugas berulang seperti tool calling, coding subtasks, dan document parsing yang kompleks.
- Cost-Efficiency: Menawarkan kecerdasan per dolar yang lebih tinggi dibandingkan kompetitor, dengan biaya operasional sekitar 1/3 dari Claude Haiku 5.5 untuk tingkat performa yang sama.
- Agentic Optimization: Arsitektur model disetel khusus untuk alur kerja agen, termasuk routing permintaan, ekstraksi data, dan pemrosesan dokumen panjang.
- Benchmark Performance: Mengalahkan GPT-6 Luna di seluruh pengaturan reasoning, membuktikan bahwa model kecil dengan teknik reasoning yang tepat bisa melampaui model yang lebih besar.
Analisis DO-AI:
Muse Ember adalah validasi dari tesis "Small Models, Big Reasoning." Bagi arsitek sistem, ini berarti kita bisa memindahkan logika decision-making yang kompleks dari model frontier yang mahal ke model edge atau small-core yang jauh lebih murah tanpa mengorbankan akurasi. Penghematan biaya hingga 70% dibandingkan Haiku 5.5 memungkinkan implementasi agen AI skala massal yang sebelumnya tidak masuk akal secara ekonomi (unit economics). Fokus pada tool calling menunjukkan bahwa Meta ingin mendominasi lapisan orkestrasi dalam ekosistem AI.
3. Anthropic Claude Fable 5.2 & Mythos 5.2: Lebih Cepat dan Lebih Murah
Sorotan Berita:
Anthropic memperbarui lini model teknis mereka dengan merilis Claude Fable 5.2 dan Mythos 5.2. Kedua model ini menggunakan arsitektur dasar yang sama namun dengan lapisan keamanan yang berbeda; Fable tersedia untuk umum dengan filter keamanan ketat, sementara Mythos ditujukan untuk riset biomedis dan keamanan siber melalui program verifikasi khusus. Pembaruan ini membawa peningkatan signifikan pada kemampuan coding, penalaran, dan visi, sembari menurunkan harga dan meningkatkan kecepatan generasi output hingga 30%. Dalam pengujian internal, model ini bahkan mampu memformalkan bukti Fermat’s Last Theorem hanya dalam waktu 30 jam.
- Performance Boost: Generasi output 30% lebih cepat dibandingkan versi 5.1, dengan opsi Fast Mode yang mampu meningkatkan kecepatan hingga 2,5 kali lipat.
- Pricing Strategy: Harga diturunkan menjadi $8 per juta token input dan $40 per juta token output, membuatnya lebih kompetitif untuk beban kerja produksi skala besar.
- Specialized Capabilities: Peningkatan tajam dalam tugas teknis berat seperti migrasi perangkat lunak yang kompleks, desain perangkat elektronik dari nol, dan penyelesaian masalah fisika lubang hitam.
Analisis DO-AI:
Langkah Anthropic merilis dua varian (Fable dan Mythos) dari model yang sama adalah pendekatan pragmatis terhadap dilema keamanan AI. Dengan memisahkan guardrails di level akses, bukan di level arsitektur, mereka bisa memberikan performa maksimal untuk riset sensitif tanpa membahayakan publik. Bagi tim pengembang, peningkatan kecepatan 30% dan penurunan harga adalah sinyal kuat untuk mulai memindahkan beban kerja heavy-reasoning ke Claude, terutama dengan adanya Fast Mode yang krusial untuk aplikasi real-time yang membutuhkan penalaran mendalam.
Matriks Perbandingan Eksekutif Pagi Ini
| Dispatch |
Core Domain |
Production Maturity |
DO-AI Recommendation |
| Google TPU 8-Series |
Infrastructure |
High (Cloud Native) |
Gunakan 8tx untuk beban kerja data sensitif/regulasi. |
| Meta Muse Ember |
Efficiency / Agents |
Emerging (Leaderboard King) |
Prioritaskan untuk orkestrasi agen dan tool calling massal. |
| Claude 5.2 Series |
Reasoning / Coding |
High (Production Ready) |
Ideal untuk migrasi kode kompleks dan riset teknis berat. |