Kilas Berita: Claude's Text Output Now Carries & Top 3 Sorotan Arsitektur?
1. Claude Kini Menyisipkan Watermark Invisible pada Output Teks
Sorotan Berita:
Anthropic secara resmi mulai mengintegrasikan teknologi watermarking berbasis SynthID-Text ke dalam model Claude terbaru mereka untuk mematuhi regulasi EU AI Act. Berbeda dengan metode tradisional yang menambahkan karakter tersembunyi, teknik ini bekerja dengan memberikan "dorongan" (nudging) pada pemilihan kata-kata yang memiliki makna serupa (near-equivalent) selama proses generasi teks. Hal ini membuat output teks mengandung pola statistik unik yang dapat dideteksi oleh alat verifikasi, namun tetap tidak terlihat oleh mata manusia dan tidak merusak kualitas narasi.
- Teknologi SynthID-Text: Menggunakan algoritma probabilistik untuk memodifikasi pemilihan token tanpa mengubah semantik atau menambah jumlah token pada output.
- Kepatuhan EU AI Act: Langkah ini merupakan respons langsung terhadap regulasi Uni Eropa yang mewajibkan penyedia model AI frontier untuk menandai konten hasil AI demi transparansi.
- Privasi & Metadata: Watermark ini tidak menyimpan informasi pribadi pengguna atau metadata identitas; fungsinya murni untuk mengidentifikasi bahwa teks tersebut dihasilkan oleh model Claude.
Analisis DO-AI:
Dari perspektif arsitektur, langkah Anthropic ini adalah trade-off cerdas antara kepatuhan regulasi dan user experience. Dengan menggunakan probabilistic nudging daripada hidden characters atau zero-width spaces, mereka menjaga integritas teks agar tetap kompatibel dengan downstream processing (seperti copy-paste ke kode atau dokumen resmi) tanpa merusak parser. Bagi tim engineering, ini adalah sinyal bahwa deteksi konten AI akan menjadi standar industri, namun tantangan teknis tetap ada pada robustness watermark tersebut terhadap teknik paraphrasing manual atau serangan adversarial yang mencoba menghapus jejak statistik tersebut.
2. Perplexity JOLT: Metode Self-Distillation Baru untuk Efisiensi Model
Sorotan Berita:
Perplexity memperkenalkan JOLT, sebuah metode self-distillation inovatif yang melatih model untuk berperan sebagai guru (teacher) dan murid (student) secara bersamaan dalam satu proses training. JOLT memecahkan masalah umum dalam distillation tradisional di mana instruksi dari model besar seringkali terlalu kompleks untuk diserap oleh model yang lebih kecil. Dengan JOLT, umpan balik dari "guru" disesuaikan secara dinamis mengikuti kapabilitas "murid" saat itu juga, yang terbukti meningkatkan performa pada tugas-tugas penalaran matematis dan coding.
- Joint Training Architecture: Melatih model dalam loop yang sama sehingga model belajar mengoreksi dirinya sendiri dengan tingkat kesulitan yang adaptif.
- Peningkatan Performa: Menunjukkan hasil signifikan pada mathematical reasoning, penulisan kode, dan tugas-tugas berbasis agen (agentic tasks).
- Efisiensi Training: Mengurangi kebutuhan akan dataset eksternal yang masif karena model mengoptimalkan transfer pengetahuan secara internal.
Analisis DO-AI:
JOLT menggeser paradigma distillation dari sekadar transfer pengetahuan statis menjadi dynamic co-evolution. Masalah utama pada model kecil seringkali adalah "halusinasi" karena mencoba meniru model besar tanpa memahami logika dasarnya; JOLT memitigasi ini dengan memastikan feedback loop tetap berada dalam reach kapasitas kognitif model tersebut. Untuk arsitek AI, ini adalah teknik krusial untuk membangun model on-device atau model spesifik domain yang tetap memiliki ketajaman logika setara model frontier tanpa beban komputasi yang membengkak.
3. Strategi Cerebras Menjalankan Model Frontier 3 Triliun Parameter
Sorotan Berita:
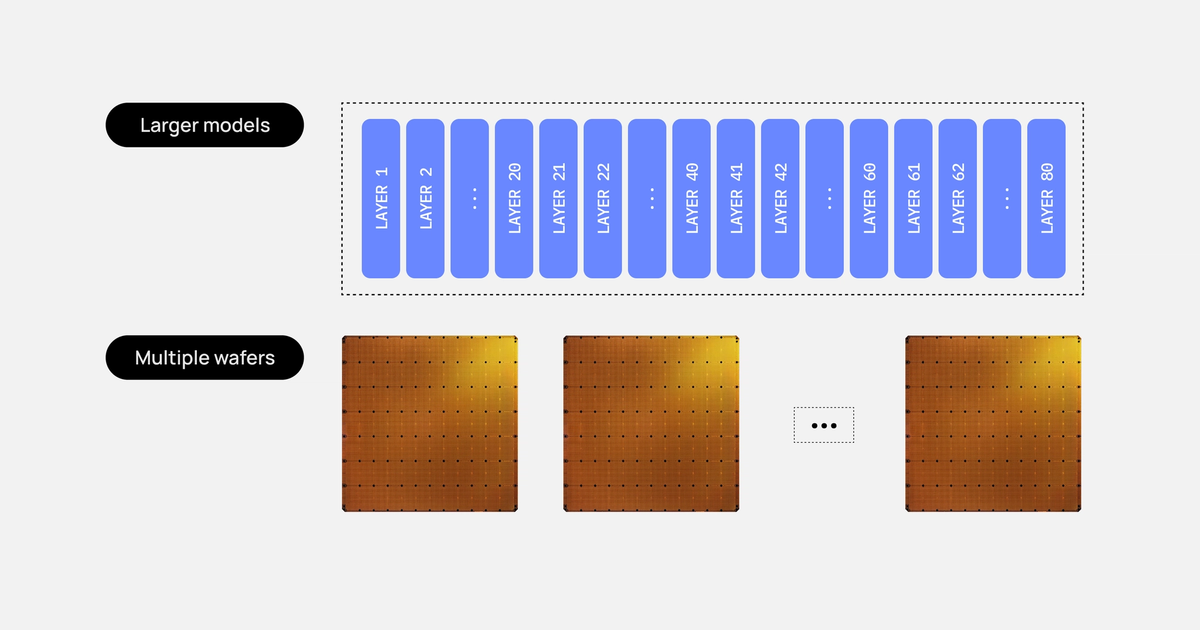
Cerebras mendemonstrasikan kapabilitas infrastruktur mereka dalam menjalankan model raksasa Kimi K3 yang memiliki 3 triliun parameter dengan kecepatan impresif 1000-2000 token per detik. Mengingat satu wafer WSE-3T "hanya" memiliki 44 GB memori on-chip, Cerebras menggunakan strategi pemetaan layer yang sangat spesifik di mana model dibagi ke dalam beberapa wafer. Teknik ini melibatkan penggunaan kuantisasi bobot 4-bit dan pemanfaatan arsitektur linear-attention untuk mengelola penggunaan memori KV cache yang masif pada model skala triliun parameter.
- Wafer-Scale Mapping: Membagi 3T parameter ke dalam payload per layer sebesar ~16 GB, yang kemudian didistribusikan secara strategis di seluruh klaster wafer WSE-3T.
- Kuantisasi 4-bit & 8-bit KV Cache: Mengoptimalkan penyimpanan parameter agar muat dalam SRAM on-chip yang sangat cepat namun terbatas secara kapasitas.
- Linear-Attention Advantage: Berbeda dengan dense layers, linear-attention pada Kimi K3 memungkinkan penyimpanan state yang tetap (fixed-size) per permintaan, menghemat ruang memori secara signifikan.
Analisis DO-AI:
Keberhasilan Cerebras membuktikan bahwa untuk model skala frontier, memory bandwidth adalah penentu utama performa, bukan sekadar jumlah inti komputasi. Penggunaan hardware-software co-design—di mana arsitektur model (seperti linear-attention) disesuaikan dengan karakteristik fisik chip (wafer-scale SRAM)—adalah satu-satunya cara mencapai inference real-time pada skala triliun parameter. Bagi organisasi yang membangun infrastruktur AI, ini menegaskan bahwa ketergantungan pada GPU tradisional akan menghadapi bottleneck latensi interkoneksi yang tidak akan ditemukan pada sistem integrasi skala wafer seperti ini.
Matriks Perbandingan Eksekutif Pagi Ini
| Dispatch |
Core Domain |
Production Maturity |
DO-AI Recommendation |
| Claude Watermarking |
AI Governance |
High (Live) |
Implementasikan deteksi untuk audit kepatuhan konten. |
| JOLT Distillation |
Model Optimization |
Emerging (R&D) |
Evaluasi untuk optimasi model internal/SLM. |
| Cerebras 3T Deployment |
AI Infrastructure |
High (Enterprise) |
Pertimbangkan untuk kebutuhan inference skala ultra-besar. |