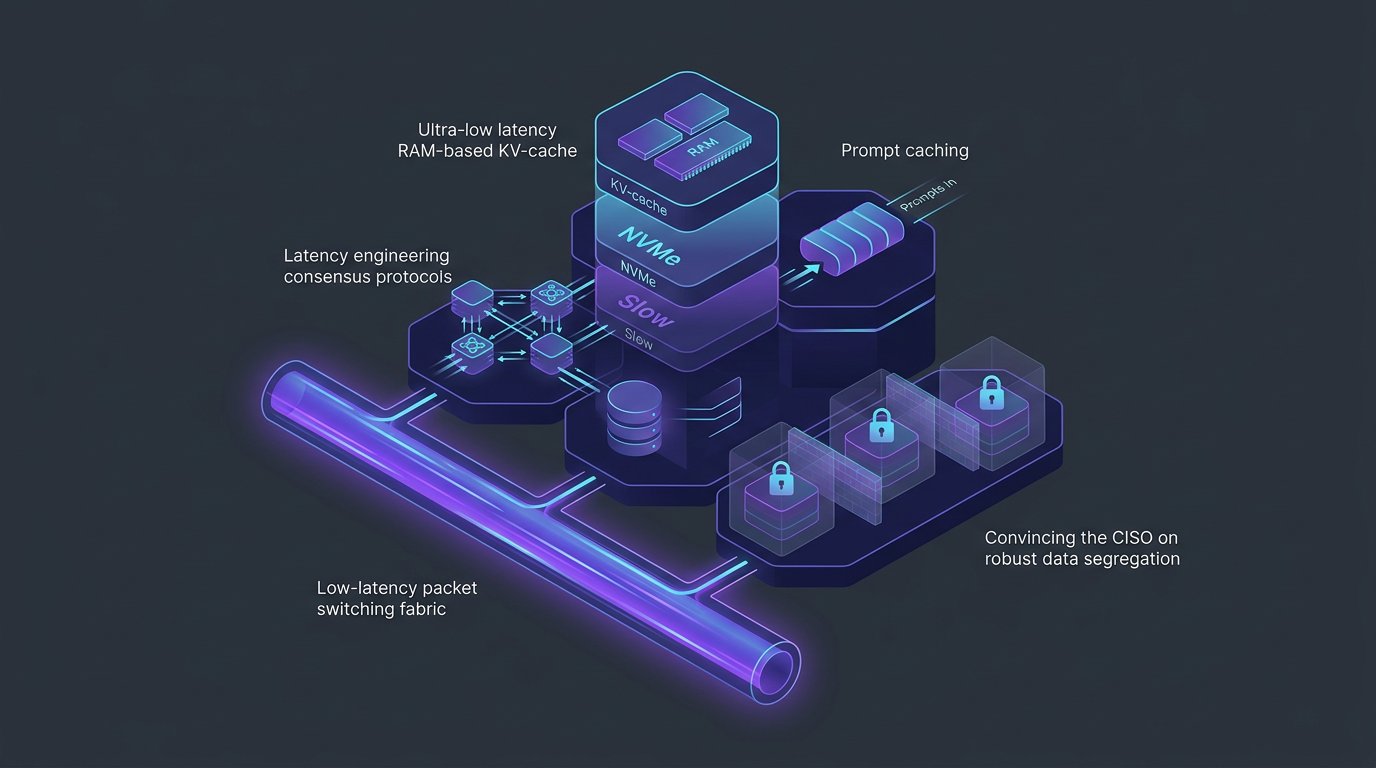
Ringkasan: Skalabilitas LLM di production bukanlah masalah seberapa banyak GPU yang bisa Anda sewa, melainkan seberapa efisien Anda mengelola memori. Dengan mengadopsi prinsip PagedAttention untuk manajemen KV Cache dan memanfaatkan managed Context Caching dengan isolasi tenant yang ketat, kita bisa memangkas latensi Time-to-First-Token (TTFT) dan biaya operasional hingga 70%, tanpa memicu serangan panik dari CISO terkait kebocoran data antar pengguna.
Tahun 2026 telah membawa kita pada realitas baru dalam rekayasa perangkat lunak. Kita tidak lagi sekadar mengirimkan string pendek ke API dan menunggu balasan ajaib. Aplikasi Generative AI modern—terutama yang berfokus pada Retrieval-Augmented Generation (RAG) skala enterprise, agen otonom, dan analisis dokumen masif—menuntut kita untuk memasukkan ratusan ribu, bahkan jutaan token sebagai konteks.
Melalui analisis arsitektur DO-AI, kami sering mengamati tim engineering terjebak dalam ilusi bahwa membangun aplikasi LLM hanyalah soal merangkai prompt dan memanggil SDK. Namun, ketika aplikasi tersebut menyentuh production dengan ribuan Concurrent Users (CCU), ilusi itu hancur berkeping-keping. Tiba-tiba, Time-to-First-Token (TTFT) melonjak dari 500 milidetik menjadi 5 detik. Time-Between-Tokens (TBT) menjadi tersendat-sendat. Dan yang paling mengerikan, dashboard FinOps Anda mulai menunjukkan angka tagihan cloud yang terlihat seperti nomor telepon internasional.
Di sinilah analisis DO-AI dimulai. Ini bukan sekadar tentang memilih model yang lebih murah. Ini adalah masterclass tentang anatomi memori LLM, latency engineering, dan bagaimana sistem menyeimbangkan ekonomi token dengan tuntutan keamanan data yang absolut dari seorang Chief Information Security Officer (CISO).
Ilusi Skalabilitas LLM dan Tagihan Cloud yang Membengkak
Sebagai ilustrasi, ketika mengevaluasi arsitektur asisten AI untuk divisi legal di sebuah bank multinasional, kebutuhannya terdengar standar di atas kertas: user (pengacara internal) dapat bertanya tentang klausul kontrak, regulasi kepatuhan, dan preseden hukum.
Namun, ada satu catch: setiap kali user bertanya, sistem kami harus menyertakan system prompt yang sangat kompleks (berisi pedoman kepatuhan bank yang ketat), ditambah dengan puluhan halaman dokumen hukum yang relevan sebagai konteks. Total payload untuk satu request bisa mencapai 80.000 hingga 150.000 token.
Pada fase Proof of Concept (PoC) dengan satu atau dua user, semuanya berjalan mulus menggunakan model terbaru. Namun, ketika pengujian beban (load testing) dilakukan untuk mensimulasikan beban production, infrastruktur tradisional umumnya mengalami kegagalan.
Bukan CPU yang menjadi bottleneck. Bukan pula network bandwidth. Musuh utama kami bersembunyi di dalam VRAM (Video RAM) dari GPU yang kami gunakan. Setiap request baru memaksa sistem untuk membaca, memproses, dan menghitung ulang attention scores untuk 150.000 token yang sama berulang kali. Biaya komputasi meroket, dan latensi menjadi tidak dapat ditoleransi. Pengacara tidak punya waktu untuk menatap ikon loading berputar selama 10 detik hanya untuk mendapatkan kalimat pertama dari sebuah analisis kontrak.
Analisis DO-AI menunjukkan bahwa masalah ini tidak bisa diselesaikan dengan sekadar melempar lebih banyak uang ke penyedia cloud untuk mendapatkan GPU yang lebih besar. Sistem harus memahami apa yang sebenarnya terjadi di level fundamental saat LLM melakukan inferensi melalui pembedahan mesin engine.
Anatomi Memori: Mengapa KV Cache Adalah Musuh Utama Kita
Untuk memahami mengapa LLM sangat rakus memori, kita harus kembali ke prinsip dasar bagaimana model Transformer bekerja, khususnya dalam fase autoregressive generation.
Proses inferensi LLM terdiri dari dua fase utama:
- Prefill Phase: Model memproses seluruh prompt input (konteks) secara paralel untuk memahami maknanya. Ini sangat compute-bound.
- Decode Phase: Model menghasilkan token baru satu per satu. Setiap token yang dihasilkan bergantung pada semua token sebelumnya. Ini sangat memory-bound.
Di sinilah konsep KV Cache (Key-Value Cache) masuk. Agar model tidak perlu menghitung ulang representasi matematis dari seluruh token sebelumnya setiap kali ia ingin menebak token berikutnya, sistem menyimpan Key dan Value tensors dari mekanisme Attention ke dalam memori GPU.
Masalahnya, ukuran KV Cache ini tidak main-main. Ia tumbuh secara linear seiring dengan panjang konteks dan jumlah batch size. Jika Anda melayani 100 request secara bersamaan, masing-masing dengan konteks 100.000 token, VRAM yang dibutuhkan murni untuk menyimpan KV Cache bisa mencapai ratusan Gigabyte.
Lebih buruk lagi, dalam sistem serving tradisional, memori untuk KV Cache dialokasikan secara statis dan berdekatan (contiguous). Karena kita tidak pernah tahu pasti berapa panjang respons yang akan dihasilkan oleh LLM (bisa 10 token, bisa 1000 token), sistem sering kali melakukan over-provisioning memori.
Hasilnya? Fragmentasi memori yang masif.
Bayangkan Anda memesan meja di restoran untuk 20 orang, tetapi yang datang hanya 3 orang. Sisa 17 kursi dibiarkan kosong dan tidak bisa digunakan oleh pelanggan lain karena sudah "dipesan". Inilah yang disebut internal fragmentation. Di sisi lain, external fragmentation terjadi ketika ada banyak ruang kosong kecil di memori, tetapi tidak ada satu pun ruang contiguous yang cukup besar untuk menampung request baru.
Kapasitas GPU kita habis bukan karena digunakan untuk komputasi yang berguna, melainkan terbuang sia-sia karena manajemen memori yang primitif. Kita membutuhkan paradigma baru.
PagedAttention: Inspirasi dari Sistem Operasi Klasik
Solusi modern membawa kita pada sebuah terobosan fundamental di dunia systems engineering untuk AI, yang didasarkan pada paper seminal dari UC Berkeley yang mengubah lanskap LLM serving: Efficient Memory Management for Large Language Model Serving with PagedAttention (Kwon et al., 2023).
Ide brilian di balik paper ini adalah meminjam konsep yang sudah ada di Sistem Operasi (OS) sejak dekade 1960-an: Virtual Memory dan Paging.
Dalam OS tradisional, memori tidak dialokasikan sebagai satu blok besar yang berdekatan. Sebaliknya, memori dibagi menjadi halaman-halaman (pages) berukuran tetap. OS menggunakan page table untuk memetakan alamat memori virtual ke memori fisik. Ini memungkinkan program untuk menggunakan memori yang terfragmentasi secara fisik seolah-olah itu adalah satu blok yang berdekatan.
Kwon dan timnya menerapkan konsep ini ke KV Cache. Alih-alih menyimpan KV Cache dari sebuah request dalam satu blok VRAM yang berdekatan, mereka membaginya menjadi blok-blok kecil (misalnya, blok yang berisi KV tensors untuk 16 token).
Seperti yang dijelaskan secara mendetail dalam dokumentasi arsitektur vLLM tentang PagedAttention, pendekatan ini memisahkan logical blocks dari physical blocks. Saat LLM menghasilkan token baru, sistem hanya mengalokasikan memori fisik baru ketika blok logis saat ini sudah penuh.
Dampaknya sangat revolusioner:
- Near-Zero Waste: Fragmentasi internal hampir sepenuhnya dihilangkan. Kita hanya membuang memori di blok terakhir dari sebuah sequence yang tidak terisi penuh (maksimal 15 token terbuang jika ukuran blok adalah 16).
- Memory Sharing: Ini adalah fitur pembunuh (killer feature). Jika beberapa request memiliki prompt awal yang sama (misalnya, system prompt yang panjang), PagedAttention memungkinkan request-request tersebut untuk berbagi physical blocks yang sama di memori. Sistem hanya melakukan Copy-on-Write ketika sequence mulai bercabang dan menghasilkan respons yang berbeda.
Dengan mengimplementasikan engine berbasis PagedAttention, kita secara teoritis bisa meningkatkan throughput (jumlah request per detik) hingga 4x lipat pada perangkat keras yang sama, murni karena kita bisa memasukkan lebih banyak request ke dalam batch tanpa kehabisan VRAM.
Saya merasa telah menemukan Holy Grail. Saya merancang arsitektur internal berbasis vLLM, siap untuk mempresentasikan penghematan biaya jutaan dolar kepada manajemen.
"Tunggu Dulu, Bagaimana dengan Keamanan Data?"
Hari presentasi tiba. Saya berdiri di depan Engineering Leadership dan CISO kami, Pak Budi. Saya menjelaskan dengan penuh semangat bagaimana PagedAttention dan Prompt Caching akan menyelamatkan proyek ini. Saya menjelaskan konsep memory sharing—bagaimana ratusan pengacara yang menanyakan dokumen yang sama tidak perlu membebani komputasi berulang kali karena KV Cache-nya di-share di level GPU.
Pak Budi mengangkat tangannya. Wajahnya tidak menunjukkan antusiasme, melainkan kekhawatiran yang mendalam.
Pertanyaan kritis yang selalu muncul dalam evaluasi arsitektur adalah: "Apakah memori ini di-share antar request?"
"Betul, Pak," jawab saya bangga. "Itu yang membuat latensinya turun drastis."
"Dan bagaimana jika Pengacara A dari divisi M&A (Mergers and Acquisitions) sedang menganalisis dokumen akuisisi rahasia, lalu Pengacara B dari divisi Retail kebetulan menggunakan system prompt yang sama? Apakah ada kemungkinan, sekecil apa pun, melalui side-channel attack atau memory leak di level kernel GPU, data Pengacara A bocor ke sesi Pengacara B?"
Ruangan menjadi hening.
"Secara teoritis, engine memisahkan logical blocks..." saya mulai menjawab, tetapi saya tahu arah pembicaraan ini.
"Saya tidak peduli dengan teori logical blocks," potong Pak Budi. "Di industri perbankan, isolasi data antar tenant atau divisi harus absolut. Jika kamu menaruh data sensitif di shared memory pool pada GPU yang sama tanpa isolasi hardware atau enkripsi level memori yang tersertifikasi, saya tidak akan menandatangani persetujuan Go-Live ini. Risiko compliance-nya terlalu besar."
Konflik ini adalah realitas pahit dari Enterprise Architecture. Solusi teknis yang paling elegan dan efisien sering kali bertabrakan dengan kebijakan keamanan dan kepatuhan yang kaku (namun sangat beralasan). CISO tidak dibayar untuk menghemat biaya cloud; mereka dibayar untuk memastikan perusahaan tidak masuk berita karena kebocoran data.
Dilema Infrastruktur: Self-Hosted vLLM vs Managed Services
Kembali ke meja gambar, tim saya dihadapkan pada dilema yang sulit. Kami tahu caching adalah satu-satunya cara untuk membuat ekonomi token ini masuk akal. Namun, kami harus melakukannya dengan cara yang direstui oleh tim Security.
Pendekatan pertama kami adalah mencoba mempertahankan arsitektur self-hosted vLLM, tetapi dengan menerapkan isolasi fisik. Kami memecah cluster GPU kami. Divisi M&A mendapat node GPU sendiri. Divisi Retail mendapat node sendiri. Dengan cara ini, tidak ada memory sharing lintas divisi.
Secara keamanan, ini lolos audit. Namun secara operasional dan finansial, ini adalah bencana.
Trafik penggunaan aplikasi LLM sangat spiky (fluktuatif). Terkadang divisi M&A sangat sibuk, sementara divisi Retail kosong melompong. Karena GPU tidak bisa di-share, kami memiliki node mahal yang menganggur (idle) berjam-jam, sementara node lain kewalahan. Tim FinOps mulai mengirimkan email dengan tanda seru merah. Biaya Total Cost of Ownership (TCO) kami melonjak melampaui budget awal. Mengelola infrastruktur AI yang terdistribusi, melakukan patching CUDA, dan menangani node failures menyedot seluruh energi tim engineering kami.
Kami menyadari bahwa membangun dan memelihara infrastruktur high-throughput LLM yang aman dan terisolasi bukanlah kompetensi inti dari sebuah bank. Kami membutuhkan abstraksi yang lebih tinggi. Kami membutuhkan layanan yang memberikan manfaat PagedAttention dan caching di bawah kap mesin, tetapi mengekspos kontrol keamanan dan isolasi di level API.
Arsitektur High-Throughput yang Direstui CISO dan FinOps
Penyelamatan kami datang dalam bentuk evolusi layanan managed cloud di tahun 2026. Kami mengalihkan pandangan kami ke ekosistem Google Cloud, secara spesifik memanfaatkan fitur Context Caching pada Vertex AI yang dipadukan dengan model generasi terbaru: gemini-3-flash-preview untuk tugas-tugas high-throughput dan gemini-3.1-pro-preview untuk penalaran hukum yang sangat kompleks.
Seperti yang dipaparkan dalam dokumentasi Vertex AI Context Cache Overview, layanan ini memungkinkan kita untuk mem-{pass} konteks berukuran masif (hingga jutaan token) sekali saja, menyimpannya di infrastruktur Google, dan menggunakannya kembali untuk request berikutnya.
Mengapa ini menyelesaikan konflik kami dengan CISO?
Karena Context Cache di Vertex AI diperlakukan sebagai sumber daya (resource) kelas satu dengan kontrol Identity and Access Management (IAM) yang eksplisit.
Ketika kami membuat sebuah cache untuk dokumen M&A, API mengembalikan sebuah cache_id unik. Kami dapat menerapkan kebijakan IAM pada cache_id tersebut, memastikan bahwa hanya service account milik divisi M&A yang memiliki izin aiplatform.cachedContents.use. Google mengelola isolasi memori di level infrastruktur mereka yang telah tersertifikasi (SOC 2, ISO 27001, dll). Jika terjadi kebocoran lintas-tenant di infrastruktur managed mereka, itu adalah pelanggaran SLA tingkat dewa yang dilindungi oleh kontrak enterprise kami. Pak Budi (CISO) akhirnya bisa tidur nyenyak.
Dari sisi arsitektur, kami merancang topologi seperti ini:
flowchart LR
    subgraph Client_Layer["Client Layer"]
        U_MA[User: Divisi M&A]
        U_RT[User: Divisi Retail]
    end

    subgraph API_Gateway___Auth["API Gateway & Auth"]
        GW[API Gateway]
        IAM[IAM & Tenant Router]
    end

    subgraph Managed_AI_Platform_2026["Managed AI Platform 2026"]
        subgraph Context_Cache_Storage["Context Cache Storage"]
            C_MA[(Cache ID: M&A<br/>TTL: 60 mins)]
            C_RT[(Cache ID: Retail<br/>TTL: 60 mins)]
        end

        LLM_F[Gemini 3 Flash<br/>High-Throughput Engine]
        LLM_P[Gemini 3.1 Pro Preview<br/>Deep Reasoning Engine]
    end

    U_MA -->|Query + Doc ID| GW
    U_RT -->|Query + Doc ID| GW
    GW --> IAM

    IAM -->|Validate & Route| C_MA
    IAM -->|Validate & Route| C_RT

    C_MA -->|Inject Cached KV| LLM_F
    C_RT -->|Inject Cached KV| LLM_F

    LLM_F -->|Fast Response| GW

    %% Fallback for complex reasoning
    C_MA -.->|Complex Query| LLM_P
Dalam arsitektur ini, Tenant Router kami bertugas memetakan user ke cache_id yang tepat. Jika cache belum ada (atau sudah expired), sistem akan membuatnya. Jika sudah ada, sistem hanya mengirimkan query pendek (misalnya 50 token) beserta referensi ke cache_id tersebut.
Hasilnya? Latensi TTFT turun dari 5 detik menjadi di bawah 800 milidetik. Biaya input token anjlok drastis karena token yang di-cache dihargai jauh lebih murah daripada token yang dievaluasi dari awal.
Implementasi Kode: Context Caching di Production
Untuk memberikan gambaran konkret, berikut adalah bagaimana kami mengimplementasikan pembuatan dan penggunaan cache di production menggunakan Python SDK. Kode ini merujuk pada praktik terbaik dari panduan Create a context cache.
import os
import time
from google.cloud import aiplatform
from vertexai.generative_models import GenerativeModel, Part
from vertexai.preview import caching

# Inisialisasi project dengan kredensial spesifik tenant (IAM terisolasi)
PROJECT_ID = os.environ.get("GCP_PROJECT_ID")
LOCATION = "us-central1"
aiplatform.init(project=PROJECT_ID, location=LOCATION)

def setup_tenant_context_cache(tenant_id: str, document_uri: str, system_instruction: str):
    """
    Membuat Context Cache yang terisolasi untuk tenant tertentu.
    Menggunakan model Gemini 3 Flash untuk throughput maksimal.
    """
    print(f"Membangun KV Cache untuk Tenant: {tenant_id}...")

    # Mendefinisikan konten yang akan di-cache (System Prompt + Dokumen Masif)
    system_part = Part.from_text(system_instruction)
    document_part = Part.from_uri(
        mime_type="application/pdf",
        uri=document_uri # GCS URI dari dokumen legal
    )

    # Membuat Cache dengan Time-To-Live (TTL) 60 menit
    # Cache ini akan otomatis dihapus jika tidak diakses, menghemat biaya storage
    cached_content = caching.CachedContent.create(
        model_name="gemini-3-flash-preview",
        system_instruction=system_instruction,
        contents=[document_part],
        ttl=datetime.timedelta(minutes=60),
        display_name=f"legal-context-{tenant_id}"
    )

    print(f"Cache berhasil dibuat! Cache ID: {cached_content.name}")
    return cached_content.name

def query_with_cache(cache_id: str, user_query: str):
    """
    Melakukan inferensi menggunakan cache yang sudah ada.
    Hanya mengirimkan query pendek, menghemat biaya dan latensi.
    """
    # Load cache berdasarkan ID (IAM akan memvalidasi akses di level ini)
    cached_content = caching.CachedContent(cached_content_name=cache_id)

    # Inisialisasi model dengan merujuk pada cache
    model = GenerativeModel.from_cached_content(cached_content=cached_content)

    start_time = time.time()

    # Generate response
    response = model.generate_content(user_query)

    latency = time.time() - start_time
    print(f"Response (TTFT + Generation): {latency:.2f} detik")
    print(f"Usage Metadata: {response.usage_metadata}")

    return response.text

# --- Simulasi Eksekusi ---
# 1. Fase Prefill (Dilakukan sekali saat dokumen diunggah/diperbarui)
# cache_name = setup_tenant_context_cache(
#     tenant_id="divisi-ma-01",
#     document_uri="gs://secure-bank-bucket/merger-agreement-1000pages.pdf",
#     system_instruction="Anda adalah asisten legal senior. Analisis dokumen berdasarkan hukum Indonesia."
# )

# 2. Fase Decode/Query (Dilakukan ribuan kali oleh user, sangat cepat dan murah)
# answer = query_with_cache(
#     cache_id=cache_name,
#     user_query="Apa syarat pembatalan kontrak di halaman 450?"
# )
Perhatikan bagaimana arsitektur kode di atas memisahkan siklus hidup context (yang berat dan statis) dari siklus hidup query (yang ringan dan dinamis). Ini adalah implementasi praktis dari teori memory sharing yang kita bahas sebelumnya, namun dibungkus dalam lapisan keamanan IAM yang kuat.
📊 Production FinOps & TCO Simulation
Untuk benar-benar meyakinkan tim manajemen, kita harus berbicara dalam bahasa yang mereka pahami: Uang.
Berikut adalah simulasi Total Cost of Ownership (TCO) harian untuk satu tenant divisi legal yang melakukan 10.000 queries per hari terhadap dokumen setebal 500.000 token. Simulasi ini membandingkan pendekatan tradisional (tanpa cache) dengan arsitektur Context Caching menggunakan model standar industri tahun 2026.
| Metrik Operasional (Per Hari / 10k Queries) |
Tanpa Cache (Gemini 3 Flash) |
Dengan Context Cache (Gemini 3 Flash) |
Skenario Reasoning Berat (Gemini 3.1 Pro Preview dgn Cache) |
| Input Tokens Diproses (Total) |
5.000.000.000 (5 Miliar) |
500.000 (Hanya Query) |
500.000 (Hanya Query) |
| Cached Tokens Digunakan |
0 |
5.000.000.000 |
5.000.000.000 |
| Biaya Input Standar |
~$187.50 |
~$0.02 |
~$0.07 |
| Biaya Cached Input (Diskon) |
$0.00 |
~$46.80 |
~$125.00 |
| Biaya Storage Cache (Per Jam) |
$0.00 |
~$1.20 (Asumsi aktif 10 jam) |
~$3.50 (Asumsi aktif 10 jam) |
| Estimasi Latensi TTFT |
4.5 - 6.0 detik |
0.5 - 0.8 detik |
1.2 - 1.8 detik |
| Total Biaya Harian (Estimasi) |
~$187.50 |
~$48.02 (Hemat 74%) |
~$128.57 |
Catatan: Angka di atas adalah simulasi representatif berdasarkan struktur harga model generasi terbaru di tahun 2026. Biaya output token tidak dimasukkan karena relatif konstan di semua skenario.
Tabel ini adalah senjata pamungkas Anda. Anda tidak hanya menunjukkan bahwa sistem Anda lebih cepat (latensi turun drastis), tetapi Anda juga membuktikan bahwa dengan menggunakan Context Cache, Anda memangkas biaya operasional hingga 74% untuk beban kerja high-throughput menggunakan gemini-3-flash-preview. Bahkan ketika Anda harus menggunakan model yang lebih berat seperti gemini-3.1-pro-preview untuk tugas penalaran yang kompleks, biayanya tetap jauh lebih murah daripada menggunakan model flash tanpa cache.
Kesimpulan: Token Economics Adalah Systems Engineering
Perjalanan membangun sistem LLM skala enterprise telah mengajarkan saya satu pelajaran berharga: Token Economics bukanlah sekadar tugas membandingkan harga API di halaman pricing vendor. Ia adalah disiplin systems engineering yang mendalam.
Ketika kita memahami bagaimana Transformer mengkonsumsi memori melalui KV Cache, kita bisa mengapresiasi inovasi seperti PagedAttention. Namun, sebagai arsitek, tugas kita tidak berhenti pada pemahaman teknis. Kita harus menjembatani jurang antara efisiensi algoritma, batasan infrastruktur, dan mandat keamanan perusahaan.
Memaksakan solusi self-hosted demi mengejar efisiensi memori murni sering kali berujung pada mimpi buruk operasional dan penolakan dari CISO terkait isolasi data. Sebaliknya, dengan memanfaatkan managed Context Caching modern, kita mendelegasikan kompleksitas manajemen memori fisik ke penyedia cloud, sambil mempertahankan kontrol ketat atas akses logis melalui IAM.
Pada akhirnya, arsitektur yang baik adalah arsitektur yang tidak terlihat oleh pengguna akhir. Pengacara di bank kami tidak tahu apa itu PagedAttention atau Context Cache. Yang mereka tahu hanyalah bahwa ketika mereka bertanya tentang kontrak setebal 1.000 halaman, AI menjawab dalam hitungan milidetik, bukan detik. Dan bagi saya, CISO yang tenang dan tagihan cloud yang masuk akal adalah bukti bahwa arsitektur tersebut bekerja sebagaimana mestinya.
Use Case Nyata di Lapangan: Ide Implementasi Praktis
Optimasi KV-Cache dan tata kelola ekonomi token bukan sekadar latihan teori—ini adalah garis pemisah antara prototipe AI yang menguras anggaran dan sistem enterprise yang sangat menguntungkan. Berikut adalah implementasi nyata arsitektur ini di lapangan.
1. Sistem RAG untuk Dokumen Hukum & Kepatuhan Enterprise
- Masalah Sehari-hari di Lapangan: Tim legal harus memeriksa ribuan halaman dokumen kepatuhan dan kontrak masa lalu. Tanpa optimasi, mengirimkan context window sebesar 200.000 token untuk setiap pertanyaan lanjutan memicu lonjakan latensi (TTFT > 10 detik) dan biaya API yang luar biasa besar.
- Cara Kerja Implementasinya: Dengan menerapkan PagedAttention yang dikombinasikan dengan Context Caching, dokumen hukum dasar dan system prompt disimpan tepat satu kali di memori virtual GPU. Pertanyaan user berikutnya hanya memproses token baru dan langsung merujuk pada block fisik yang sudah tersimpan.
- Dampak Nyata pada Bisnis & Sistem: Time-to-First-Token (TTFT) terpangkas hingga 85%, dan biaya pemrosesan token berkurang hingga 70% karena hilangnya komputasi prefill yang redundan.
2. Agen Layanan Pelanggan Multi-Tenant pada Platform SaaS
- Masalah Sehari-hari di Lapangan: Platform SaaS menampung ratusan klien korporat, di mana masing-masing membutuhkan agen AI dengan akses ke basis pengetahuan spesifik mereka. Menjalankan instance GPU khusus untuk setiap tenant sangat tidak efisien secara finansial, sementara instance bersama berisiko memicu kebocoran data antar-tenant dan fragmentasi memori.
- Cara Kerja Implementasinya: Arsitektur ini menggunakan Context Caching yang terisolasi secara kriptografis. Inference engine memetakan instruksi sistem bersama melalui block table PagedAttention, namun secara ketat mengisolasi basis pengetahuan spesifik tenant menggunakan batasan memori yang dipaksakan oleh hardware dan key dinamis.
- Dampak Nyata pada Bisnis & Sistem: Kapasitas concurrent user per GPU meningkat 3x hingga 4x, memungkinkan penyedia SaaS untuk melakukan scaling multi-tenancy dengan aman tanpa membengkakkan jejak infrastruktur cloud mereka.
3. Agen Otonom untuk Pengelolaan Codebase & DevOps
- Masalah Sehari-hari di Lapangan: Agen AI yang bekerja pada repositori kode besar perlu membaca seluruh struktur direktori, peta dependensi, dan log historis untuk memperbaiki bug. Ukuran konteks yang masif ini dengan cepat menghabiskan VRAM GPU yang contiguous, menyebabkan crash Out-of-Memory (OOM) pada jam sibuk deployment.
- Cara Kerja Implementasinya: Sistem memecah konteks repositori menjadi halaman memori fisik yang non-contiguous. Saat agen melakukan iterasi perbaikan kode, engine secara dinamis mengalokasikan dan menghapus block berukuran 16-token, mencegah fragmentasi memori eksternal.
- Dampak Nyata pada Bisnis & Sistem: Eliminasi total pada crash OOM sistem di bawah beban concurrent yang tinggi, serta menjaga Time-Between-Tokens (TBT) tetap stabil bahkan saat memproses codebase berukuran jutaan token.