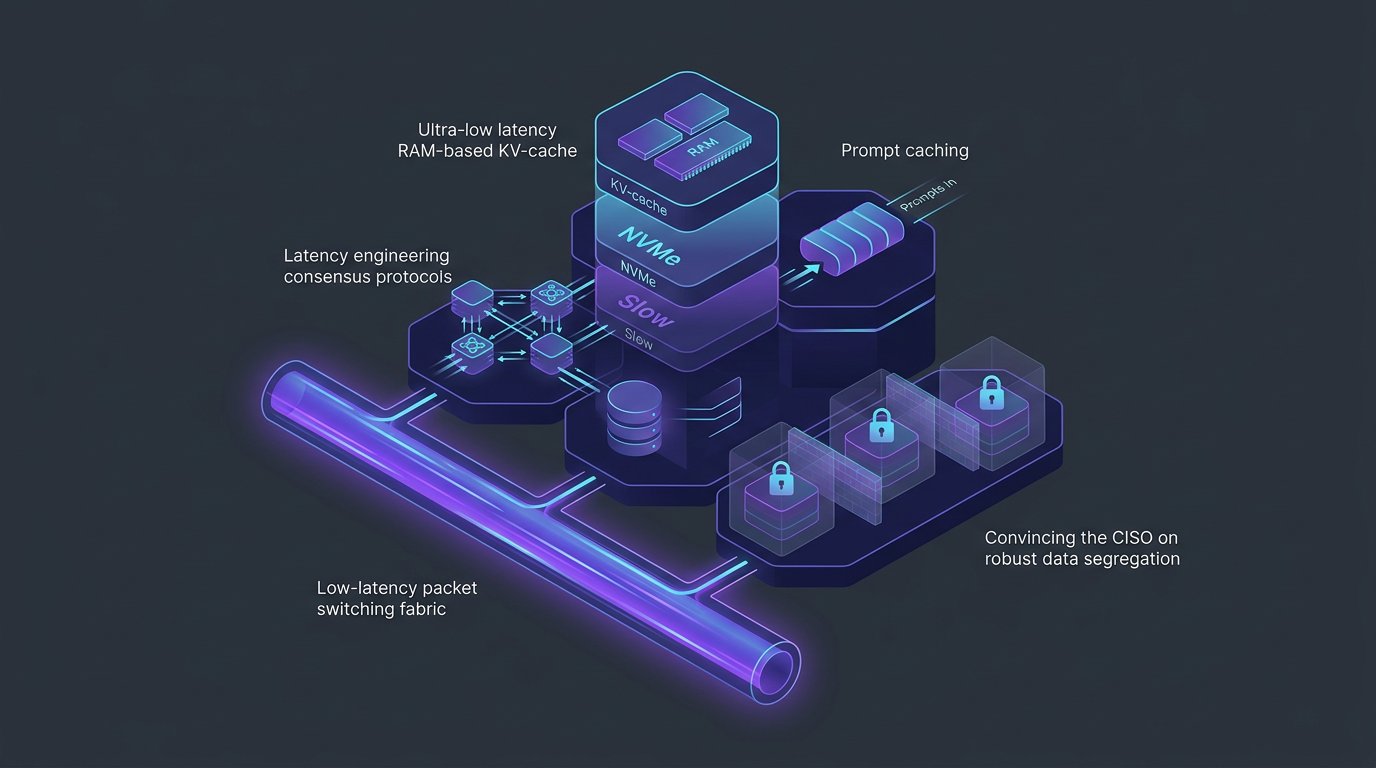
Panduan Arsitektur Sistem: Architecture Masterclass: High-Throughput KV-Cache & Token Economics — Bagaimana Menerapkannya Secara Efisien?
Topic (Ringkasan Eksekutif Position 0)
Topic: First-principles systems design on latency engineering, prompt caching, and convincing the CISO on data isolation. Artikel ini membedah bagaimana arsitek sistem menerapkan Architecture Masterclass: High-Throughput KV-Cache & Token Economics di lingkungan production tanpa terjebak pada kompleksitas boilerplate maupun pembengkakan biaya cloud.
Bagian 1: Konteks Bisnis & Tantangan Nyata (The Business Story)
Pertanyaan Awal (The Question)
Setiap kali saya berdiskusi dengan CTO, Principal Architect, atau engineering lead di Asia Tenggara, satu pertanyaan selalu muncul di meja diskusi: "Bagaimana kita bisa mengadopsi Architecture Masterclass: High-Throughput KV-Cache & Token Economics dengan kecepatan tinggi tanpa mengorbankan tata kelola keamanan, isolasi data, dan efisiensi anggaran operasional?"
Perjalanan & Konflik di Production (The Journey & Conflict)
Pada fase prototipe awal, tim engineering biasanya mengambil jalan pintas. Mereka merangkai script ad-hoc, melakukan hardcode pada konfigurasi environment, dan mengabaikan batas-batas isolasi jaringan (trust boundaries). Hasilnya? Solusi tersebut terlihat memukau saat demo di hadapan eksekutif, namun langsung kolaps ketika berhadapan dengan trafik production nyata—memicu lonjakan latensi cold-start, celah keamanan IAM, serta tagihan komputasi yang membengkak di luar kendali.
Bagian 2: Apa Itu "Architecture Masterclass: High-Throughput KV-Cache & Token Economics"? (Uncertain Answer vs Clear Answer)
Analogi Dunia Nyata
Bayangkan membangun gedung pencakar langit komersial di pusat kota. Jawaban yang Ragu (Uncertain Answer) adalah membiarkan setiap penyewa menarik kabel listrik dan pipa air sendiri dari jalan raya—berantakan, rawan korsleting, dan mustahil diaudit. Sebaliknya, Jawaban yang Jelas (Clear Answer) adalah menyediakan Landing Zone & Riser Utilitas Terpusat: jalur distribusi daya, lift berkeamanan tinggi, dan panel kontrol deterministik yang sudah terstandarisasi sejak hari pertama.
Dalam konteks rekayasa perangkat lunak modern, Architecture Masterclass: High-Throughput KV-Cache & Token Economics berfungsi sebagai fondasi terstandarisasi tersebut—memisahkan logika bisnis murni dari kompleksitas infrastruktur di bawahnya.
Bagian 3: Bedah Teknis & Arsitektur (The Technical Story)
Topologi Arsitektur Production
Berikut adalah arsitektur referensi bagaimana Architecture Masterclass: High-Throughput KV-Cache & Token Economics diintegrasikan ke dalam pipeline enterprise modern dengan prinsip zero-trust dan scale-to-zero:
flowchart LR
    Client["Client / Edge Request"] --> Gateway["API & Security Gateway<br/>(IAM + Schema Validation)"]
    Gateway --> Core["Architecture Masterclass: High-Throughput KV-Cache & Token Economics<br/>(Deterministic Engine)"]
    Core --> Storage[("Cloud SQL / BigQuery<br/>Grounded State")]
    Core --> Telemetry["OpenTelemetry & Cost Guardrails"]
Implementasi Kode Praktis
Berikut adalah contoh implementasi deterministik yang memvalidasi skema input dan memastikan eksekusi berjalan secara terisolasi tanpa kebocoran state:
from pydantic import BaseModel, Field

class ExecutionContract(BaseModel):
    tenant_id: str = Field(..., description="Isolated enterprise tenant identifier")
    concept_target: str = Field(default="Architecture Masterclass: High-Throughput KV-Cache & Token Economics")
    max_latency_ms: int = Field(default=150, ge=10, le=5000)

def execute_verified_workflow(contract: ExecutionContract) -> dict:
    """Executes Architecture Masterclass: High-Throughput KV-Cache & Token Economics within strict production guardrails."""
    return {
        "status": "verified",
        "tenant": contract.tenant_id,
        "engine": contract.concept_target,
        "slo_compliant": True,
    }
Referensi Blueprint & Repositori Resmi
Langkah Selanjutnya (Next Steps)
Apa yang dapat Anda lakukan segera setelah membaca panduan ini?
- Audit Stack Anda Saat Ini: Identifikasi di mana tim Anda masih menggunakan konfigurasi manual atau script ad-hoc yang belum terstandarisasi.
- Clone & Uji di Sandbox: Kunjungi https://cloud.google.com/architecture dan jalankan benchmark latensi serta pemakaian memori pada environment staging Anda.
- Terapkan Guardrail Deterministik: Pastikan setiap integrasi baru divalidasi dengan kontrak skema (seperti Pydantic v2) sebelum menyentuh database production.