Inilah realitas yang tidak nyaman bagi banyak tim rekayasa yang men-deploy Large Language Model (LLM) di production: kemungkinan besar Anda sedang membuang 60% hingga 80% kapasitas memori GPU termahal Anda secara sia-sia.
Saat organisasi menghadapi kendala throughput pada serving LLM, reaksi spontan mereka biasanya adalah meminta tambahan anggaran GPU—memesan cluster NVIDIA H100 atau L4 dengan biaya cloud yang fantastis. Namun, ketika Anda membedah profil penggunaan High Bandwidth Memory (HBM) pada node-node tersebut saat beban puncak, Anda akan mendapati bahwa sebagian besar VRAM tersebut tidak sedang menyimpan bobot model ataupun menghitung perkalian matriks. Memori tersebut menganggur total, terkunci oleh strategi reservasi Key-Value (KV) cache yang kaku dan tidak efisien.
Engine inferensi konvensional memperlakukan alokasi memori seperti memesan satu pesawat komersial berkapasitas 350 penumpang hanya untuk satu keluarga kecil beranggotakan tiga orang—hanya untuk berjaga-jaga jika sewaktu-waktu mereka memutuskan mengajak 20 kerabat di menit-menit terakhir.
Di sinilah vLLM hadir membawa terobosan arsitektur memori: PagedAttention.
Dengan mengadopsi konsep sistem operasi yang dirumuskan sejak era 1960-an—yaitu paging memori virtual—vLLM mentransformasi efisiensi biaya serving LLM, mendongkrak throughput token 2x hingga 4x lipat pada hardware yang persis sama. Dalam bedah arsitektur ini, kita akan membongkar bagaimana PagedAttention dan fitur Chunked Prefill di v0.7 melenyapkan fragmentasi memori untuk selamanya.
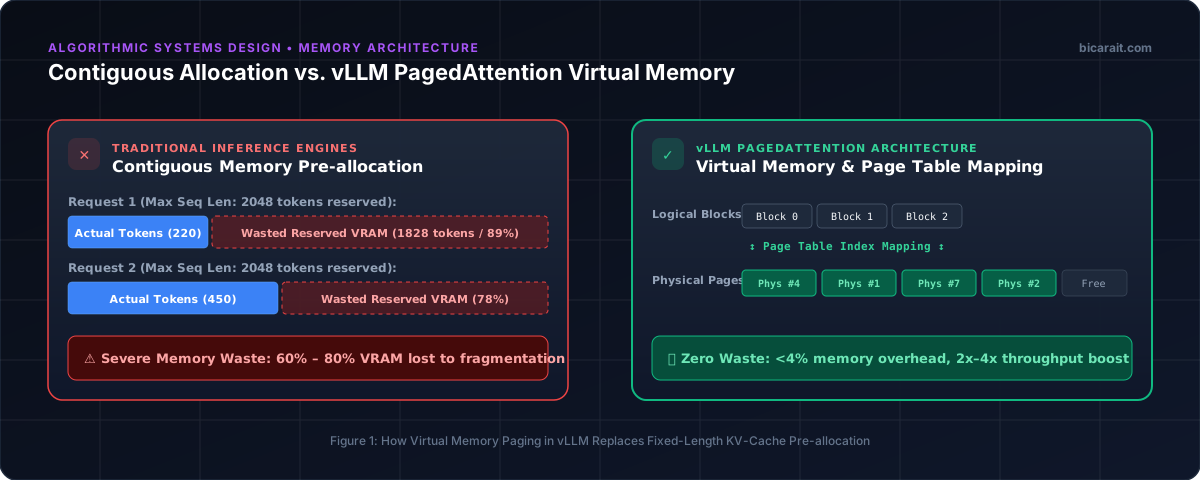 Gambar 1: Perbandingan Alokasi KV-Cache Bersebelahan Tradisional vs. Pemetaan Blok Virtual vLLM PagedAttention.
💡 Cetak Biru Eksekutif (TL;DR)
💡 Cetak Biru Eksekutif (TL;DR)
vLLM adalah engine inferensi LLM open-source ber-throughput tinggi yang bertumpu pada PagedAttention, sebuah algoritma yang mempartisi Key-Value (KV) cache ke dalam blok-blok memori fisik berukuran tetap yang tidak harus berurutan (non-contiguous). Dengan menggantikan reservasi memori statis bersebelahan memakai tabel blok virtual, vLLM hampir melenyapkan seluruh pemborosan memori, memungkinkan continuous batching masif dan peningkatan densitas serving token hingga 10x lipat.
┌─────────────────────────────────────────────────────────────────────────────┐
│                 MEMORI KONTIGU vs. PAGEDATTENTION                           │
├─────────────────────────────────────────────────────────────────────────────┤
│ Alokasi Kontigu Tradisional (Pemborosan 60-80% VRAM):                       │
│ [Token KV Req 1] [_______Reservasi Statis Terbuang: max_len_______]         │
│ [Token KV Req 2] [_______Reservasi Statis Terbuang: max_len_______]         │
├─────────────────────────────────────────────────────────────────────────────┤
│ vLLM PagedAttention (Nol Pemborosan, Utilitas Memori ~96%):                 │
│ Token Logis:     [Blok 0: 16t] ──➔ [Blok 1: 16t] ──➔ [Blok 2: 16t]          │
│ HBM Fisik GPU:   [Frame GPU 41]    [Frame GPU 08]    [Frame GPU 93]         │
└─────────────────────────────────────────────────────────────────────────────┘
📊 Matriks Perbandingan Engine Serving LLM
| Fitur / Engine |
vLLM (v0.7+) |
Ollama / llama.cpp |
TensorRT-LLM |
HuggingFace TGI |
| Arsitektur Utama |
PagedAttention + Chunked Prefill |
GGUF Quantized CPU/Metal |
Kernel-Fused TensorRT |
FlashAttention v2 / Paged |
| Target Deployment |
API Server Konkurensi Tinggi |
Workstation Lokal / Mac |
Bare-Metal Nvidia Puncak |
Microservices Enterprise |
| Utilitas Memori |
~96% (Dynamic Paging) |
Buffer Tetap |
Tinggi (Pre-allocated) |
Sedang-Tinggi |
| Inferensi Terdistribusi |
Ray & Tensor Parallel Native |
Single Node / CPU |
MPI Clustered Kompleks |
Kubernetes Native |
| Throughput (Rasio QPS/$) |
Pemimpin Industri |
Rendah (Single Stream) |
Tinggi (Hardware Kaku) |
Moderat |
🔬 Blueprint Arsitektur 1: Akar Masalah Fragmentasi KV Cache
Selama proses generasi teks autoregresif, setiap token baru yang dihasilkan harus memperhatikan (attend) seluruh token sebelumnya di dalam sequence. Agar tidak perlu menghitung ulang tensor attention dari nol di setiap langkah, vektor Key dan Value dari token-token sebelumnya disimpan di dalam memori GPU (disebut KV Cache).
Pada framework generasi awal, sebuah request baru langsung dialokasikan blok memori kontigu berurutan sebesar context window maksimum model (misalnya 4.096 atau 8.192 token). Ini memicu dua kegagalan arsitektural fatal:
- Fragmentasi Internal: Jika prompt dan respon pengguna hanya memakai 300 token, sisa 3.796 token dari memori GPU berkecepatan tinggi yang telah dipesan akan terkunci membeku dan tidak dapat digunakan request lain.
- Fragmentasi Eksternal: Berbagai request datang dan selesai pada waktu yang acak. Setelah beberapa menit berjalan, memori fisik menjadi seperti papan catur dengan celah-celah kecil terputus, sehingga request baru yang masuk tidak dapat menemukan satu blok memori kontigu yang cukup besar.
🔬 Blueprint Arsitektur 2: Cara Kerja Sebenarnya PagedAttention
PagedAttention mengatasi masalah ini dengan memisahkan secara tegas antara representasi urutan logis dan tata letak memori fisik:
- Blok KV Berukuran Tetap: Cache attention dipecah menjadi blok-blok kecil yang menampung jumlah token tetap (biasanya 16 atau 32 token per blok).
- Tabel Blok (The Block Table): Persis seperti cara page table pada kernel sistem operasi memetakan alamat virtual memory ke frame RAM fisik, vLLM memelihara tabel blok dinamis yang memetakan indeks blok urutan logis $L_i$ ke alamat fisik di dalam HBM GPU.
- Alokasi On-Demand: Ketika sebuah urutan menghasilkan token baru, engine hanya mengalokasikan blok fisik baru saat blok saat ini telah penuh. Blok-blok fisik ini tidak perlu berurutan di dalam memori.
Berbagi Memori Fisik (Parallel Sampling & Beam Search)
Karena blok-blok diakses melalui pointer referensi, beberapa output yang berasal dari prompt awal yang sama (seperti temperature sampling $N=4$ atau eksplorasi tree-of-thought) dapat menunjuk ke blok fisik prompt yang persis sama. KV cache dari prompt hanya disimpan satu kali, menghemat konsumsi memori prompt hingga 75%.
🔬 Blueprint Arsitektur 3: Chunked Prefill (Terobosan v0.7)
Bahkan dengan PagedAttention, generasi engine awal masih menghadapi kendala Prefill Bottleneck:
- Fase Prefill: Memproses prompt input sangat intensif komputasi (perkalian matriks paralel pada seluruh token input).
- Fase Decode: Menghasilkan token satu per satu sangat intensif bandwidth memori.
Ketika seorang pengguna mengirimkan dokumen panjang sebesar 32.000 token, GPU terpaksa menghentikan sementara seluruh aliran decode yang sedang berjalan untuk memproses prefill tersebut, memicu lonjakan latensi (latency jitter) bagi pengguna lain secara real-time.
Chunked Prefill memecahkan masalah ini dengan memotong prompt panjang menjadi chunk mikro (misalnya 512 token), lalu menyelipkan (interleaving) komputasi prefill dengan langkah decode token di dalam satu iterasi eksekusi GPU yang sama.
# Deployment vLLM Production dengan Chunked Prefill & Speculative Decoding
from vllm import LLM, SamplingParams

# Inisialisasi engine serving ber-throughput tinggi
llm = LLM(
    model="meta-llama/Meta-Llama-3.1-8B-Instruct",
    tensor_parallel_size=1,            # Skala multi-GPU via Ray
    gpu_memory_utilization=0.94,       # Maksimalkan utilisasi HBM
    enable_chunked_prefill=True,       # Interleave langkah prefill & decode
    max_num_batched_tokens=2048,       # Alokasi batch optimal per langkah
    max_model_len=8192,
)

# Parameter sampling konkurensi tinggi
sampling_params = SamplingParams(
    temperature=0.2,
    top_p=0.9,
    max_tokens=1024,
)

# Kirim batch asinkron streaming
prompts = [
    "Jelaskan topologi Shared VPC terdistribusi di Google Cloud.",
    "Rancang layout banner AdSense zero-CLS di Next.js 15.",
]

outputs = llm.generate(prompts, sampling_params)

for output in outputs:
    print(f"Berhasil menghasilkan {len(output.outputs[0].token_ids)} token.")
🎯 Kesimpulan Rekayasa Sistem
vLLM memberikan pelajaran berharga dalam rekayasa sistem klasik: ketika menghadapi bottleneck komputasi modern, kembalilah melihat prinsip dasar sistem operasi.
Sebelum Anda mengajukan permohonan pengadaan hardware GPU baru, auditlah terlebih dahulu efisiensi memori dari engine inferensi Anda. Beralih dari framework transformer konvensional ke PagedAttention dan Chunked Prefill vLLM dapat langsung mengembalikan hingga 80% throughput GPU yang hilang tanpa mengeluarkan uang tambahan untuk infrastruktur.
Use Case Nyata di Lapangan: Ide Implementasi Praktis
Implementasi vLLM bukan sekadar mengejar benchmark teknis; ini tentang kelayakan ekonomi dari produk AI Anda. Di DO-AI, kami melihat tiga skenario berikut sebagai pendorong utama adopsi PagedAttention dan Chunked Prefill di lingkungan produksi.
1. Agen Layanan Pelanggan dengan Konkurensi Tinggi
- Masalah Sehari-hari di Lapangan: Saat trafik puncak, bot layanan pelanggan menjadi lambat atau mengembalikan error "out of memory" karena setiap sesi pengguna memesan blok VRAM statis yang besar, meskipun mereka hanya mengetik "Halo".
- Cara Kerja Implementasinya: Dengan vLLM, sistem menggunakan PagedAttention untuk mengalokasikan KV cache secara dinamis. Seiring berkembangnya percakapan, memori diberikan dalam blok kecil 16-token, memungkinkan server menangani ratusan pengguna bersamaan pada satu GPU L4.
- Dampak Nyata pada Bisnis & Sistem: Peningkatan kapasitas pengguna konkuren sebesar 3x hingga 5x per node GPU, yang secara langsung memangkas biaya cloud hingga 60%.
2. Analisis Dokumen Konteks Panjang (Hukum & Medis)
- Masalah Sehari-hari di Lapangan: Memproses ringkasan hukum 50 halaman sering kali menyebabkan "Prefill Spikes" di mana seluruh sistem membeku selama beberapa detik untuk membaca dokumen, merusak pengalaman pengguna lain di cluster yang sama.
- Cara Kerja Implementasinya: Fitur Chunked Prefill pada vLLM v0.7 memecah dokumen 50 halaman tersebut menjadi potongan-potongan kecil. Engine menyisipkan pemrosesan potongan ini di sela-sela proses generasi token pengguna lain.
- Dampak Nyata pada Bisnis & Sistem: Menghilangkan gejala "sistem membeku" dan mengurangi jitter latensi P99 hingga 90% pada layanan LLM multi-tenant.
3. Penulisan Kreatif Multi-Varian & A/B Testing
- Masalah Sehari-hari di Lapangan: Saat alat pemasaran menghasilkan lima versi iklan berbeda dari prompt yang sama, engine standar menyimpan KV cache prompt tersebut lima kali secara terpisah, membuang ber-GB memori.
- Cara Kerja Implementasinya: vLLM menggunakan berbagi memori fisik. KV cache untuk prompt awal hanya disimpan satu kali, dan kelima aliran generasi merujuk ke blok fisik yang sama hingga teks mulai berbeda.
- Dampak Nyata pada Bisnis & Sistem: Pengurangan penggunaan memori hingga 70% untuk tugas sampling paralel, memungkinkan penalaran "Tree-of-Thought" yang lebih kompleks dalam skala besar.