
Berhenti Memaksa Penyair Jadi Boolean: Mengapa Jev dari TypeSafe AI dan System One Mengubah Segalanya
TL;DR: Selama tiga tahun terakhir, kita sebagai arsitek enterprise telah membakar $15 per juta token dan menunggu 4 hingga 8 detik waktu autoregressive GPU hanya untuk memaksa Large Language Model (LLM) berbasis percakapan mengembalikan nilai boolean atau memilih satu enum dari daftar. Dengan hadirnya TypeSafe AI dan model System One perdananya, Jev (
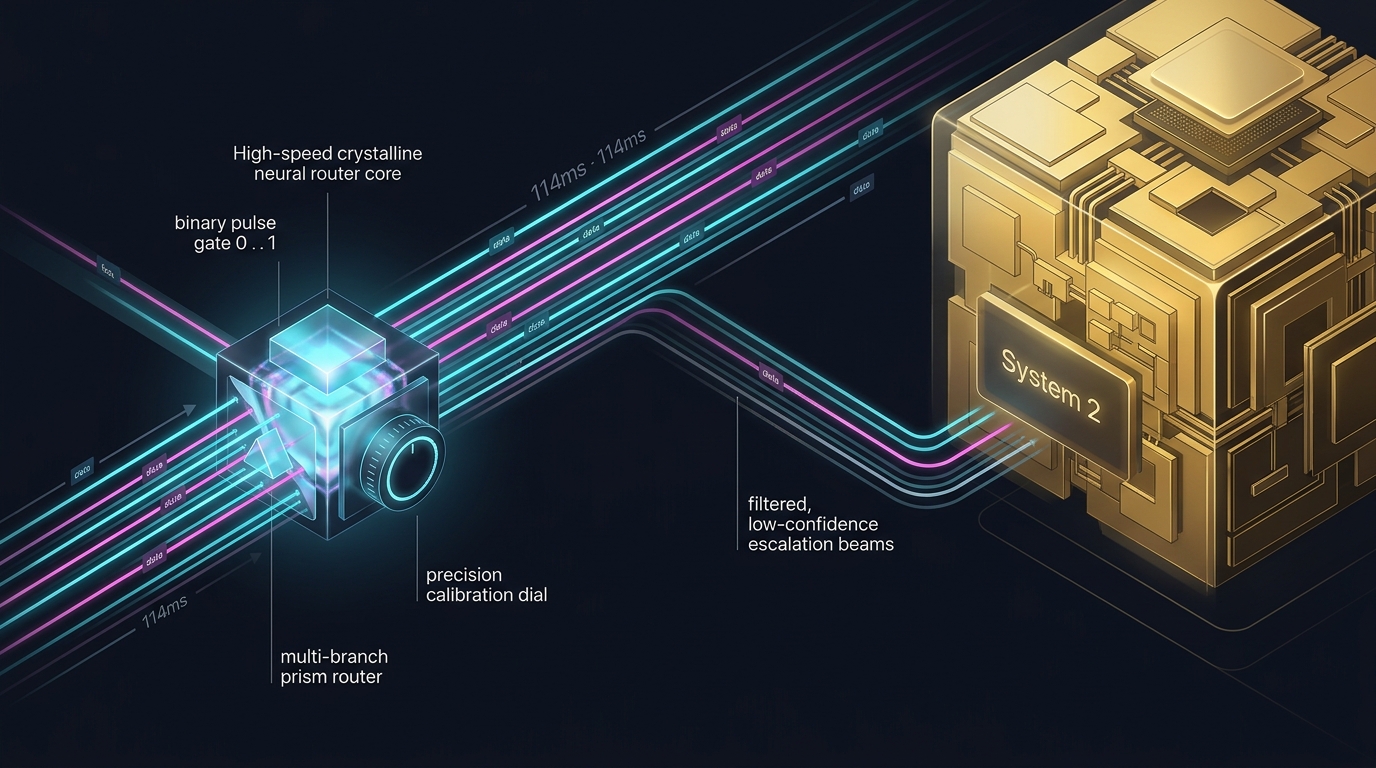
jev-1.13.0)—yang dibangun oleh rekan pencipta RLHF, Diogo Almeida, menggunakan Reinforcement Learning for Calibrated Decisions (RLCD)—kita akhirnya memiliki primitif keputusan machine-native (Choice,Score, danNoul) yang mengevaluasi state dalam satu parallel pass berdurasi 114 milidetik dengan biaya hanya $42 per satu miliar input tokens. Berikut adalah bedah arsitektur saya mengenai mengapa dual-process cognitive routing (System 1 Jev + System 2 Gemini 3.1 Pro) adalah standar produksi baru.
Setiap beberapa bulan di dunia rekayasa perangkat lunak (software engineering), selalu ada satu rilis teknologi yang memaksa kita berhenti sejenak, menatap diagram topologi microservice di papan tulis, dan mengakui bahwa selama ini kita telah melakukan sesuatu yang sebenarnya konyol secara arsitektural.
Minggu ini, momen tersebut menghantam saya saat menonton ulasan teknis mendalam dari Sam Witteveen, "Jev - The Ultimate Classification Model?", sembari membedah spesifikasi di dokumentasi resmi System One TypeSafe AI. Di berbagai utas X, YouTube, hingga kanal Slack para principal engineer, reaksinya seragam—bukan karena ada laboratorium AI yang merilis chatbot 2 triliun parameter baru yang pandai menulis puisi, melainkan karena akhirnya ada yang membangun anti-chatbot sejati.
Dan bagian paling menariknya terletak pada siapa yang membangunnya.
TypeSafe AI, yang baru saja keluar dari mode stealth pada September 2026 dengan pendanaan awal (seed funding) sebesar $40 juta, didirikan oleh Diogo Almeida bersama Erik Gafni dan Sasha Sheng. Bagi kita yang mengikuti literatur fundamental machine learning, nama Almeida bukanlah sosok asing: saat masih di OpenAI, beliau adalah salah satu peneliti orisinal yang menciptakan RLHF (Reinforcement Learning from Human Feedback) dan InstructGPT—terobosan alignment yang mengubah pre-trained transformer mentah menjadi ChatGPT dan memulai era AI percakapan modern.
Kini, di tahun 2026, sang arsitek RLHF tersebut justru tampil di Manifesto TypeSafe AI dengan sebuah pengakuan arsitektural yang sangat jujur: untuk membangun otomasi perangkat lunak yang andal, industri AI selama ini mengambil arah riset yang keliru.
1. Absurditas Arsitektural: Memaksa Penyair Menjadi Pernyataan if
Mari kita perhatikan anatomi arsitektur AI enterprise produksi di tahun 2026. Ketika kita menginspeksi codebase backend modern yang menjalankan puluhan microservice berbasis LLM, sebagian besar dari layanan tersebut sama sekali tidak menghasilkan teks naratif untuk dibaca manusia.
Sebaliknya, service-service tersebut dipaksa mengeksekusi alur kontrol (control-flow) deterministik seperti ini:
- Membaca tiket customer support atau webhook payload yang masuk, lalu memutuskan antrean (queue) mana (
billing,technical,fraud,sales) yang harus menanganinya. - Memeriksa apakah prompt pengguna atau potongan dokumen RAG melanggar 10 aturan guardrail kepatuhan, PII, atau prompt injection (
trueataufalse). - Memberi skor pada prospek penjualan (sales lead), klaim asuransi, atau pull request diff berdasarkan rubrik keparahan 4 tingkat (
0hingga3).
Perhatikan baik-baik apa yang selama ini kita lakukan untuk mengeksekusi tugas-tugas tersebut. Kita mengambil model penalaran System Two berukuran raksasa yang bersifat autoregressive—sebuah model yang dilatih melalui RLHF agar piawai mengobrol dengan manusia kata demi kata—lalu kita membungkusnya dengan system prompt sepanjang 600 kata yang memohon: "Kamu adalah pengklasifikasi JSON yang ketat. JANGAN keluarkan blok markdown. JANGAN jelaskan alasanmu. Kembalikan HANYA objek JSON yang sesuai dengan skema Pydantic ini."
Mengapa pendekatan ini selalu terasa seperti memasang mesin mobil Formula 1 pada mesin pemotong rumput? Karena secara arsitektural, pola tersebut memiliki empat cacat bawaan yang tidak akan pernah bisa disembuhkan oleh prompt engineering secanggih apa pun:
- RLHF Merusak Kalibrasi Probabilitas (Overconfidence & Mode Dropping):
RLHF memberi penghargaan (reward) pada model ketika menghasilkan jawaban yang terdengar meyakinkan dan percaya diri di mata penilai manusia. Sebagai efek samping matematis langsung, RLHF memicu mode collapse dan menghancurkan kalibrasi probabilitas. Jika Anda meminta LLM percakapan berbasis RLHF untuk mengeluarkan angka
"confidence"antara0.0hingga1.0, model tersebut akan secara rutin mengeluarkan0.95atau0.99bahkan ketika ia sedang menebak secara buta. Kita tidak mungkin membangun confidence-gated branching yang deterministik di Python atau Go jika nilai confidence dari model hanyalah teks halusinasi, bukan distribusi probabilitas yang terkalibrasi secara matematis. - Tail Latency Akibat Generasi Autoregressive (
8.5svs.114ms): Bahkan ketika kita mengaktifkan constrained decoding (response_schemadi Vertex AI atau Structured Outputs), LLM yang bersifat autoregressive tetap harus merangkai sintaks JSON karakter demi karakter—{,",u,r,g,e,n,t,",:,t,r,u,e,}—dan sering kali membakar 1.500 thinking tokens tersembunyi sebelum mengeluarkan kurung kurawal pertama. Pada workflow evaluasi multi-pertanyaan, benchmark produksi TypeSafe AI menunjukkan bahwa pipeline LLM tradisional membutuhkan waktu 8,566 detik, sedangkan parallel pass non-autoregressive menyelesaikannya hanya dalam 0,114 detik (114ms)—sebuah akselerasi 193,6x lebih cepat. - Context Rot Saat Mengajukan Banyak Pertanyaan Sekaligus: Jika Anda menumpuk 15 pertanyaan rubrik dan guardrail ke dalam satu prompt LLM tunggal demi menghemat network round-trip, model akan mengalami context rot dan kontaminasi silang antar-pertanyaan: jawaban model pada Pertanyaan #1 akan mendistorsi distribusi attention pada Pertanyaan #12.
- Pemborosan FinOps ($15/1M vs. $42/1B Tokens): Memakai LLM percakapan kelas frontier untuk routing berfrekuensi tinggi, triase log, dan pengecekan guardrail sebanyak 50 juta request per bulan secara diam-diam menguras ratusan ribu dolar anggaran cloud tanpa memberikan nilai tambah generatif sedikit pun.
2. Kehadiran System One & RLCD: Keputusan Terketik (Typed Decisions), Bukan String
Dalam buku klasiknya Thinking, Fast and Slow, peraih Nobel Daniel Kahneman membagi kognisi ke dalam dua mode yang sangat berbeda:
- System 1: Pengenalan pola yang cepat, otomatis, paralel, intuitif, dan terbatas (bounded)—seperti penilaian instan (gut-check) yang dibuat oleh seorang pakar domain dalam waktu 100 milidetik (
Apakah pelanggan ini sedang marah?,Apakah transaksi ini mencurigakan?). - System 2: Penalaran yang lambat, penuh upaya, sekuensial, dan deliberatif—seperti menulis dokumen RFC arsitektur sepanjang 2.000 kata, mensintesis patch kode multi-langkah, atau membuktikan teorema matematika.
Selama empat tahun terakhir, industri AI menggelontorkan 99% modalnya untuk memperbesar skala System 2 (RLHF untuk model chat seperti GPT dan Claude, disusul RLVR—Reinforcement Learning with Verifiable Rewards—untuk model penalaran chain-of-thought). Sementara itu, para software engineer di lapangan justru sangat membutuhkan System 1 yang machine-native.
Itulah celah fundamental yang dijawab oleh TypeSafe AI melalui Jev (jev-1.13.0).
Alih-alih menggunakan RLHF, TypeSafe AI melatih Jev dengan algoritma pelatihan baru bernama RLCD (Reinforcement Learning for Calibrated Decisions). Jev tidak menghasilkan prosa, tidak bisa diajak mengobrol, dan tidak mengeluarkan token satu per satu. Anda mengirimkan sebuah state (tiket support tak terstruktur, event log JSON, code diff, atau transkrip finansial) bersama kamus (dictionary) berisi pertanyaan terketik (typed questions), lalu Jev mengevaluasi seluruh pertanyaan tersebut secara paralel dan terisolasi hanya dalam satu forward pass tunggal.
flowchart TD
    subgraph ClientApp["Enterprise Microservice / Event Pipeline"]
        Req["Incoming State Payload<br/>(Ticket, Log, Diff, or User Prompt)"]
    end

    subgraph SystemOne["TypeSafe AI Jev — System One Parallel Gate (114ms @ $42/1B Tokens)"]
        direction LR
        P1["Noul Primitive (0..1)<br/>is_prompt_injection: 0.02<br/>is_urgent: 0.98"]
        P2["Choice Primitive<br/>department: 'technical'<br/>confidence: 0.89"]
        P3["Score Primitive<br/>frustration: 2.0 (High)<br/>confidence: 0.94"]
    end

    subgraph RouterLogic["Deterministic Code Branching (Python / TypeScript)"]
        Gate{"Confidence >= 0.80<br/>& Safe Noul Gate?"}
        FastPath["Fast-Path Execution (85% Traffic)<br/>Direct DB / Queue Dispatch<br/>Zero LLM Token Spend"]
    end

    subgraph SystemTwo["Google Cloud Vertex AI — System Two Deep Reasoner"]
        Gemini["gemini-3.1-pro-preview<br/>Complex Root-Cause Synthesis<br/>& Code Remediation (15% Traffic)"]
    end

    Req -->|"Single POST /v1/systemone"| SystemOne
    SystemOne -->|"Typed Probabilities + Calibrated Confidence"| Gate
    Gate -->|"Yes (114ms Total Latency)"| FastPath
    Gate -->|"No (Low Confidence / Escalation Required)"| Gemini
Perhatikan keindahan arsitektur dari topologi di atas. Karena setiap pertanyaan di dalam request POST https://api.typesafe.ai/v1/systemone dievaluasi secara independen dan paralel terhadap state masukan, mengajukan 12 pertanyaan sekaligus dalam satu panggilan API membutuhkan latensi ~114ms yang nyaris identik dengan mengajukan 1 pertanyaan saja—dan Pertanyaan #12 sama sekali tidak mengalami context rot akibat Pertanyaan #1!
3. Membedah Tiga Primitif Utama: Choice, Score, dan Noul
Hal yang paling membuat saya antusias saat mempelajari spesifikasi resmi Primitif TypeSafe AI serta bedah teknis Sam Witteveen adalah bagaimana TypeSafe mereduksi 95% kebutuhan keputusan perangkat lunak non-generatif menjadi tiga primitif yang modular dan composable.
Mari kita bedah masing-masing primitif ini dan bagaimana ketiganya mengubah cara kita menulis control flow di backend.
Primitif #1: Noul — Proposisi Biner Terkalibrasi (0.0 hingga 1.0)
Mari kita mulai dengan primitif yang paling ramai diperbincangkan di komunitas AI saat ini: Noul.
Mengapa mereka menciptakan istilah baru—Noul—ketimbang sekadar menyebutnya bool (boolean)?
Karena di dalam rekayasa perangkat lunak tradisional, bool adalah nilai biner kaku True atau False (1 atau 0), sedangkan realitas bahasa alami bersifat probabilistik. Ketika Anda meminta boolean dari LLM biasa, model tersebut menyembunyikan keraguannya di balik token diskrit true atau false.
Sebuah Noul mengevaluasi proposisi ya/tidak (yes/no) terhadap state dan mengembalikan probabilitas floating-point terkalibrasi antara 0.0 hingga 1.0 yang merepresentasikan peluang pasti bahwa pernyataan tersebut bernilai Ya (True):
noul = 0.98: Keyakinan sangat tinggi bahwa jawabannya Ya.noul = 0.01: Keyakinan sangat tinggi bahwa jawabannya Tidak.noul = 0.52: Ambiguitas nyata—kode aplikasi kita kini mengetahui secara pasti bahwa model sedang berada di area abu-abu dan dapat meneruskannya ke peninjau manusia atau LLM System 2!
Di lingkungan produksi, ini berarti kita dapat menembakkan 10 guardrail Noul secara paralel dalam satu panggilan API berdurasi 114ms:
"contains_pii_or_credentials""attempts_sql_or_prompt_injection""expresses_churn_intent""mentions_production_outage""requires_legal_compliance_review"
Alih-alih menulis ulang instruksi prompt yang rapuh setiap kali kebijakan bisnis berubah, kita cukup menggeser konstanta threshold di kode Python (if answers["expresses_churn_intent"].noul >= 0.75:).
Primitif #2: Choice — Klasifikasi Multi-Kelas dengan Distribusi Probabilitas Penuh
Primitif Choice meminta Jev memilih satu opsi dari kamus kategori yang saling eksklusif (criteria). Berbeda dengan tool-calling enum pada LLM yang hanya mengembalikan satu string pemenang, Jev mengembalikan tiga bidang krusial:
choice: Kunci opsi pemenang (misalnya"technical").probabilities: Distribusi probabilitas ternormalisasi di seluruh opsi (misalnya{"technical": 0.85, "billing": 0.15, "sales": 0.0}).confidence: Skor keyakinan epistemik (0.0hingga1.0) yang mengukur seberapa yakin model terhadap keputusannya.
Bayangkan betapa berharganya kombinasi probabilities + confidence ini untuk enterprise routing: jika sebuah tiket menghasilkan skor technical: 0.51 dan billing: 0.49, pengklasifikasi LLM biasa hanya akan mengembalikan "technical" dan secara diam-diam salah mengirim separuh tiket bug penagihan Anda. Dengan primitif Choice pada Jev, kode Anda dapat memeriksa if ans.probabilities["billing"] > 0.25 and ans.probabilities["technical"] > 0.25: dan secara otomatis menembuskan tiket tersebut ke kedua tim sekaligus!
Primitif #3: Score — Penilaian Rubrik Berurutan Tanpa Prompt Drift
Primitif Score menilai state berdasarkan daftar kriteria rubrik berurutan (dari indeks 0 hingga N-1) dan mengembalikan nilai score tertimbang, distribusi probabilities per level, legend, serta confidence.
Sebagaimana ditekankan dalam dokumentasi Quickstart TypeSafe AI, model System One bekerja paling optimal ketika kita mendekomposisi penilaian kompleks menjadi beberapa pertanyaan Score atomik, lalu menggabungkannya dengan rumus matematika di kode kita sendiri. Alih-alih meminta LLM menjawab satu pertanyaan kabur seperti "Beri nilai proposal vendor enterprise ini dari 1 sampai 100," kita mengajukan empat pertanyaan Score atomik secara paralel kepada Jev:
security_posture(rubrik 0–3)sla_completeness(rubrik 0–3)pricing_competitiveness(rubrik 0–3)migration_complexity(rubrik 0–3)
Selanjutnya, di kode Python murni, kita menghitung total_score = 0.40 * security + 0.30 * sla + 0.20 * pricing - 0.10 * complexity. Ketika CISO Anda meminta bobot keamanan dinaikkan dari 40% menjadi 55% kuartal depan, Anda cukup mengubah satu angka koefisien di Python—tanpa risiko regresi prompt dan 100% dapat diuji dengan unit test deterministik.
4. Use Case Nyata di Lapangan: 4 Ide Implementasi Praktis Jev
Bahkan jika Anda tidak menulis kode infrastruktur machine learning sehari-hari, memahami di mana model System One seperti Jev dapat diterapkan di lapangan sangat penting bagi para pemimpin produk (Product Leaders), founder, dan eksekutif bisnis. Berikut adalah empat use case lapangan yang langsung menyelesaikan masalah operasional mahal sehari-hari menggunakan Choice, Score, dan Noul:
Use Case 1: Triase Sengketa & Refund Instan di E-Commerce dan Fintech (Choice + Noul)
- Masalah Sehari-hari di Lapangan: Saat pelanggan mengajukan refund instan disertai foto struk belanja dan paragraf keluhan yang panjang, memprosesnya lewat chatbot standar memakan waktu 5 hingga 8 detik dan sering salah mengambil keputusan ketika foto bukti buram atau nomor pesanan terpotong—antara meloloskan klaim palsu (fraud) atau menolak pelanggan setia.
- Cara Kerjanya di Praktik Nyata: Tempatkan
Jevdi gerbang API pengajuan komplain. Dalam satu parallel pass berdurasi 114 milidetik,JevmengevaluasiChoice(auto_approve_refund,route_to_fraud_team,standard_return) sekaligus pemeriksaanNoul(is_receipt_legible). Jika foto struk buram atau bukti belum lengkap,Jevmengembalikan nilainoul(bukan true maupun false), yang otomatis memicu pesan WhatsApp atau pop-up aplikasi secara instan: "Mohon unggah ulang foto label pengiriman yang lebih jelas agar refund Anda bisa langsung kami setujui detik ini." - Dampak Bisnis Nyata: Lebih dari 80% pengajuan refund mikro yang valid selesai otomatis di bawah satu detik dengan biaya sepersekian sen, sementara tiket yang datanya belum lengkap langsung tertangkap sebelum menyita waktu agen customer service manusia.
Use Case 2: Guardrail Suara AI (Voice Agent) & Call Center Real-Time (Score + Choice)
- Masalah Sehari-hari di Lapangan: Perusahaan perbankan, telekomunikasi, dan maskapai yang mengimplementasikan AI Voice Agent sering mengalami jeda hening (dead-air) selama 3 hingga 5 detik setiap kali model keamanan LLM berukuran besar memeriksa apakah penelepon sedang marah atau meminta transaksi finansial yang diatur regulasi.
- Cara Kerjanya di Praktik Nyata: Jalankan
Jevsecara paralel pada setiap kalimat yang diucapkan pelanggan (latensi114ms) untuk mengevaluasiScore(tingkat frustrasi pelanggan dari0hingga3) danChoice(kategori kepatuhan). Begitu skor frustrasi menyentuh angka3atau terdeteksi sengketa kartu kredit, router langsung mengalihkan panggilan telepon secara mulus ke supervisor manusia tanpa jeda hening yang canggung. - Dampak Bisnis Nyata: Percakapan suara AI terasa alami tanpa lag, dipadukan dengan kepatuhan regulasi yang terkalibrasi secara matematis.
Use Case 3: Penilaian Ribuan Dokumen Tender (RFP), CV Rekrutmen & Kontrak Hukum (Score Rubric)
- Masalah Sehari-hari di Lapangan: Meminta chatbot LLM menilai 10.000 dokumen proposal vendor, prospek penjualan (sales leads), atau lamaran kerja pada skala
1 sampai 10selalu menghasilkan angka yang tidak konsisten (7/10di pagi hari,9/10di sore hari untuk dokumen PDF yang persis sama) serta menghabiskan ribuan dolar biaya token. - Cara Kerjanya di Praktik Nyata: Pecah kriteria penilaian menjadi 4 rubrik
ScoreJevyang independen (0–3untuk kesesuaian teknis, kesiapan kepatuhan, daya saing harga, dan risiko pengiriman) dengan biaya hanya$42 per satu miliar token. Gabungkan skor terkalibrasi tersebut di dalam rumus spreadsheet atau Python untuk menyaring 5% kandidat terbaik, lalu kirimkan hanya 5% teratas tersebut keGemini 3.1 Prountuk dibuatkan ringkasan eksekutif mendalam. - Dampak Bisnis Nyata: Peringkat evaluasi yang 100% konsisten dan dapat diaudit pada puluhan ribu dokumen dengan penghematan biaya komputasi hingga 99%.
Use Case 4: Pra-Otorisasi Klaim Kesehatan & Asuransi dengan Abstensi Aman (Noul)
- Masalah Sehari-hari di Lapangan: Dalam verifikasi klaim medis dan asuransi, memaksa model AI menjawab secara biner
Setuju / Tolak(Ya / Tidak) ketika catatan klinis dokter belum mencantumkan hasil laboratorium memicu halusinasi berbahaya dan risiko sanksi regulasi. - Cara Kerjanya di Praktik Nyata: Gunakan primitif tiga-kondisi
Noulpada setiap daftar periksa polis asuransi. Ketika lampiran medis belum memiliki kode diagnostik yang diwajibkan,Jevmengeluarkan distribusi probabilitasnoulyang tinggi—secara otomatis memberi tahu pihak rumah sakit dokumen spesifik mana yang kurang, alih-alih menebakYaatauTidak. - Dampak Bisnis Nyata: Menghapus halusinasi keputusan biner pada alur kerja berisiko tinggi sekaligus mempercepat klaim yang lengkap menjadi persetujuan instan.
5. Panduan Kode Produksi: Gateway Hibrida System 1 (Jev) + System 2 (Gemini 3.1 Pro)
Mari kita lihat bagaimana mengimplementasikan arsitektur ini di dalam microservice Python enterprise menggunakan typesafe-sdk resmi yang dipadukan dengan google-genai SDK untuk Confidence-Gated Escalation.
Pertama, pasang kedua SDK resmi di dalam environment uv Anda:
uv add typesafe-sdk google-genai pydantic
Berikut adalah pola lengkap Dual-Process Cognitive Router kelas produksi. Pada Langkah 1, kita mengeksekusi Choice, Score, dan Noul dalam satu parallel pass 114ms di Jev (jev-latest). Pada Langkah 2, kode kita melakukan percabangan deterministik berdasarkan nilai noul dan confidence dari Jev—menangani 85% tiket berkeyakinan tinggi secara instan di kode, dan hanya mengeskalasi kasus yang ambigu atau outage kritis ke gemini-3.1-pro-preview di Google Cloud Vertex AI:
import os
from dataclasses import dataclass
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient
from google import genai
from google.genai import types


@dataclass(frozen=True)
class TriageDecision:
    department: str
    frustration_score: float
    urgency_noul: float
    security_risk_noul: float
    confidence: float
    escalated_to_system_two: bool
    resolution_action: str


def evaluate_support_state_with_jev(
    ticket_state: str,
    confidence_threshold: float = 0.80,
) -> TriageDecision:
    """
    Langkah 1: Evaluasi primitif Choice, Score, dan Noul secara paralel via TypeSafe AI Jev (System 1).
    Langkah 2: Percabangan deterministik; panggil Vertex AI Gemini 3.1 Pro (System 2) HANYA jika
    epistemic confidence berada di bawah ambang batas atau membutuhkan sintesis mendalam.
    """
    ts_client = TypeSafeClient(api_key=os.environ["TYPESAFE_API_KEY"])

    # Satu panggilan paralel non-autoregressive ke POST https://api.typesafe.ai/v1/systemone
    response = ts_client.system_one(
        state=ticket_state,
        model="jev-latest",
        questions={
            "department": Choice(
                instructions="Which engineering or business unit owns this issue?",
                criteria={
                    "billing": "Invoice discrepancies, subscription tiers, or payment gateway failures",
                    "cloud_infra": "Kubernetes, Cloud Run, database latency, or IAM permission errors",
                    "security": "Suspected credential leak, unauthorized access, or CVE report",
                    "sales": "Enterprise contract expansion or custom SLA pricing inquiries",
                },
            ),
            "frustration": Score(
                instructions="How frustrated or escalated does the customer appear?",
                criteria=[
                    "0: Calm, objective technical report",
                    "1: Mildly frustrated but cooperative",
                    "2: Highly frustrated, revenue impact mentioned",
                    "3: Executive escalation or churn threat",
                ],
            ),
            "is_urgent_outage": Noul(
                instructions="The message describes an active production outage or revenue-blocking failure",
            ),
            "contains_secret_or_pii": Noul(
                instructions="The payload contains raw API keys, passwords, or personally identifiable data",
            ),
        },
    )

    dept_ans = response.answers["department"]
    frust_ans = response.answers["frustration"]
    urgent_noul = float(response.answers["is_urgent_outage"].noul)
    pii_noul = float(response.answers["contains_secret_or_pii"].noul)

    # Gerbang Keamanan Zero-Trust Deterministik menggunakan probabilitas Noul
    if pii_noul >= 0.85:
        return TriageDecision(
            department="security",
            frustration_score=float(frust_ans.score),
            urgency_noul=urgent_noul,
            security_risk_noul=pii_noul,
            confidence=float(dept_ans.confidence),
            escalated_to_system_two=False,
            resolution_action="QUARANTINE_AND_REDACT_PII_IMMEDIATELY",
        )

    # Fast-Path (System 1 Murni): Confidence tinggi & bukan outage -> selesai dalam 114ms tanpa biaya LLM
    if float(dept_ans.confidence) >= confidence_threshold and urgent_noul < 0.75:
        return TriageDecision(
            department=str(dept_ans.choice),
            frustration_score=float(frust_ans.score),
            urgency_noul=urgent_noul,
            security_risk_noul=pii_noul,
            confidence=float(dept_ans.confidence),
            escalated_to_system_two=False,
            resolution_action=f"FAST_ROUTE_TO_{str(dept_ans.choice).upper()}_QUEUE",
        )

    # Slow-Path Escalation (System 2): Panggil Vertex AI Gemini 3.1 Pro hanya untuk kasus ambigu atau P0 outage
    vertex_client = genai.Client(
        vertexai=True,
        project=os.environ["GOOGLE_CLOUD_PROJECT"],
        location="global",
    )
    synthesis = vertex_client.models.generate_content(
        model="gemini-3.1-pro-preview",
        contents=(
            f"System 1 Triage flagged this ticket (dept={dept_ans.choice}, "
            f"confidence={dept_ans.confidence:.2f}, urgent_noul={urgent_noul:.2f}). "
            f"Draft a 3-step incident mitigation plan for the on-call SRE:\n\n{ticket_state}"
        ),
        config=types.GenerateContentConfig(temperature=0.2, max_output_tokens=2048),
    )

    return TriageDecision(
        department=str(dept_ans.choice),
        frustration_score=float(frust_ans.score),
        urgency_noul=urgent_noul,
        security_risk_noul=pii_noul,
        confidence=float(dept_ans.confidence),
        escalated_to_system_two=True,
        resolution_action=synthesis.text or "ESCALATED_TO_SRE_ONCALL",
    )
Perhatikan dampak arsitektural dari fungsi 90 baris di atas:
- 85% trafik rutin langsung masuk ke jalur cepat (
Fast-Path)if float(dept_ans.confidence) >= confidence_threshold and urgent_noul < 0.75:. Proses selesai dalam 114 milidetik, hanya memakan biaya $0,000081, dan sama sekali tidak membebani kuota GPU LLM generatif Anda. - Setiap payload dengan
contains_secret_or_pii.noul >= 0.85langsung dikarantina secara deterministik sebelum sempat masuk ke vector database atau context window model pihak ketiga. - Hanya 15% tiket yang benar-benar ambigu (
confidence < 0.80) atau insiden P0 (urgent_noul >= 0.75) yang membangunkangemini-3.1-pro-preview(System 2) untuk menyusun rencana mitigasi mendalam.
6. Simulasi FinOps & TCO Produksi: LLM Murni vs. System 1 (Jev) + System 2 (Gemini 3.1 Pro)
Mari kita hitung angka keekonomian riilnya untuk skala enterprise. Anggaplah platform Anda memproses 50 juta workflow klasifikasi, scoring, dan guardrail multi-pertanyaan setiap bulan (dengan rata-rata 1.900 input tokens berisi state + definisi rubrik per evaluasi).
Berdasarkan telemetri harga dan benchmark resmi TypeSafe AI ($42 per 1 Miliar input tokens = $0,042 per 1 Juta input tokens, atau $0,000081 per workflow multi-pertanyaan, dibandingkan dengan $0,013880 dan latensi 8,566 detik pada pipeline LLM frontier standar) serta struktur harga resmi Google Cloud Vertex AI, berikut adalah perbandingan TCO bulanan dan dampaknya terhadap latensi:
📊 Production FinOps & TCO Simulation
| Pola Arsitektur (50 Juta Workflow / Bulan) | Mesin Keputusan Utama | Porsi Eskalasi ke System 2 | Latensi Evaluasi p95 | Biaya Token & API Bulanan (USD) | Penghematan Infrastruktur Tahunan |
|---|---|---|---|---|---|
| Pola Legacy A: Klasifikasi Frontier LLM Murni | Autoregressive Chat LLM ($0.01388 / workflow) |
100% berjalan di LLM System 2 | 8,566 ms (8.57s) |
$694,000 / bln |
Baseline ($0 penghematan) |
Pola B: TypeSafe AI Jev Murni (System 1 Saja) |
jev-1.13.0 ($42 / 1B tokens = $0.000081 / workflow) |
0% (Routing & scoring murni) | 114 ms (0.11s) |
$4,050 / bln |
$8,279,400 / thn (hemat 99.4%) |
| Pola C: Hybrid Dual-Process Router (Rekomendasi) | jev-1.13.0 (100% Gate) + gemini-3.1-pro-preview (15% Eskalasi) |
85% Fast-Path (Jev) / 15% Deep Synthesis (Gemini 3.1 Pro) |
114 ms (Fast-Path) / 2,400 ms (Rata-rata) |
$49,050 / bln ($4,050 Jev + $45,000 Gemini) |
$7,739,400 / thn (hemat 92.9%) |
Perhatikan kontras tajam antara Pola B dan Pola C pada tabel di atas:
- Untuk beban kerja klasifikasi murni, intent routing, dan guardrail kepatuhan
Noul(Pola B), memigrasikan trafik dari LLM percakapan keJevmemangkas tagihan bulanan dari$694.000/bulanmenjadi hanya$4.050/bulan, sekaligus menurunkan latensi p95 dari 8,5 detik menjadi 114 milidetik. - Bahkan ketika Anda mengeskalasi 15% kasus yang kompleks atau ber-confidence rendah ke
gemini-3.1-pro-previewuntuk sintesis generatif penuh (Pola C), organisasi Anda tetap menghemat lebih dari $644.000 setiap bulan (efisiensi TCO92,9%) sembari membuat 85% interaksi pengguna terasa instan.
7. Keputusan Arsitektural Kami: Di Mana Jev Menang Mutlak—dan Di Mana System 2 Tetap Tak Tergantikan
Setiap kali sebuah arsitektur terobosan seperti Jev dari TypeSafe AI viral di YouTube dan X, godaan terbesar bagi tim engineering adalah berayun dari satu ekstrem ke ekstrem lainnya. Berikut adalah batas arsitektural yang kami rekomendasikan di DO-AI bagi tim cloud dan AI untuk mengadopsi model System One di tahun 2026:
- Gunakan
Jev(System 1) untuk Setiap Penilaian Terbatas (Bounded Judgment) yang Hasilnya Dikonsumsi oleh Kode: Jika konsumen dari panggilan AI Anda adalah percabanganif/else, pernyataanswitch, pengurut antrean prioritas, filter guardrail, atau rumus scoring berbobot—berhentilah memanggil model pembuat teks. GunakanChoice,Score, danNoul. Anda akan memperoleh distribusi probabilitas terkalibrasi, skor epistemic confidence sejati, nol exception akibat gagal parsing JSON, nol context rot multi-pertanyaan, dan waktu respons ~100ms. - Pertahankan
Gemini 3.1 Pro(System 2) untuk Sintesis Terbuka, Pembuatan Kode, dan Penalaran Mendalam:Jevtidak dirancang untuk menulis skrip migrasi Python, tidak bisa merangkum kontrak akuisisi 200 halaman menjadi memo eksekutif, dan tidak melakukan eksplorasi multi-step agentic tool. Itu tetap merupakan wilayah kekuasaan System 2. - Jadikan
Confidencesebagai Primitif Arsitektur Kelas Satu: Hadiah terbesar dari RLCD (Reinforcement Learning for Calibrated Decisions) bahkan bukanlah peningkatan kecepatan 193x atau penurunan biaya 444x—melainkan fakta bahwa ketikaJevmelaporkanconfidence: 0.65, Anda benar-benar dapat mempercayai bahwa model tersebut sedang ragu. Untuk pertama kalinya, kita dapat menulis threshold eskalasi yang deterministik di dalam arsitektur cloud kita tanpa perlu menebak-nebak apakah sang model sedang menggertak.
Kita telah menghabiskan babak pertama era Generative AI untuk mengajari mesin cara berbicara layaknya penyair. Dengan hadirnya model System One seperti Jev beserta primitif Noul, Choice, dan Score, kita akhirnya mengajari mesin cara mengambil keputusan yang terkalibrasi dan type-safe dengan kecepatan eksekusi kode.