Kilas Berita: Why is Speculative Decoding Fast, ATLAS: Evaluating Agents, & Quicksand?
1. Mengapa Speculative Decoding Cepat? Bukan Karena FLOPs Lebih Sedikit
Sorotan Berita:
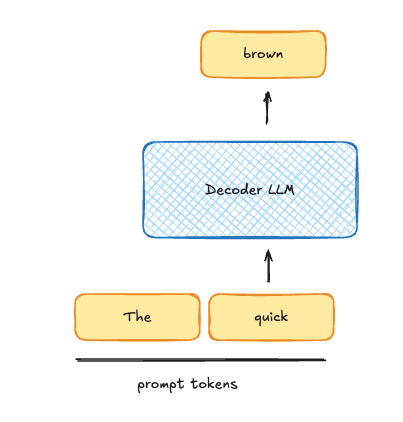
Ada miskonsepsi umum bahwa speculative decoding menjadi cepat karena melakukan pekerjaan komputasi yang lebih sedikit. Faktanya, teknik ini justru meningkatkan total floating point operations (FLOPs) yang dieksekusi. Kecepatannya bukan berasal dari efisiensi hitung, melainkan dari perubahan jenis beban kerja pada GPU—dari yang sebelumnya memory-bound menjadi compute-bound. Dengan menggunakan draft model kecil untuk menebak urutan token dan target model besar untuk memverifikasinya secara paralel dalam satu forward pass, sistem dapat memanfaatkan kapasitas komputasi GPU yang biasanya "menganggur" saat menunggu data dimuat dari memori.
- Mekanisme Verifikasi Paralel: Draft model mengusulkan urutan token, sementara model besar memverifikasi seluruh urutan tersebut sekaligus, bukan satu per satu.
- Optimasi Bandwidth Memori: LLM tradisional sering kali memory-bound (menunggu data parameter dimuat); speculative decoding menggunakan compute ekstra yang "gratis" untuk memproses banyak token sekaligus.
- Trade-off Throughput: Pada batch size kecil, teknik ini sangat efektif mempercepat latensi, namun pada throughput tinggi, teknik ini bisa membuang compute yang seharusnya digunakan untuk memindahkan memori.
- Kondisi Ideal: Sangat efektif ketika GPU memiliki headroom komputasi yang besar dibandingkan dengan kecepatan transfer data memorinya.
Analisis DO-AI:
Dari perspektif arsitektur, speculative decoding adalah strategi latency-hiding yang cerdas namun memiliki diminishing returns pada skala high-concurrency. Engineering team harus memahami bahwa ini adalah solusi untuk masalah memory wall. Jika sistem Anda melayani ribuan request simultan (di mana GPU sudah compute-bound karena batching yang padat), menambahkan speculative decoding justru bisa menurunkan efisiensi total. Gunakan teknik ini secara selektif untuk user-facing applications yang memprioritaskan time-to-first-token dan tokens-per-second pada low batch size.
2. ATLAS: Benchmark Baru untuk Menguji Ketajaman Agentic Search
Sorotan Berita:
Exa AI memperkenalkan ATLAS, sebuah benchmark baru yang dirancang khusus untuk mengevaluasi kemampuan AI agents dalam menyelesaikan tugas-tugas dunia nyata yang intensif pencarian web. Berbeda dengan benchmark tradisional yang sering kali menguji hafalan model, ATLAS fokus pada tugas-tugas yang belum ter-indeks dalam memori model (non-memorized) dan membutuhkan pencarian lintas domain yang mendalam. Hasil awal menunjukkan kesenjangan besar: bahkan agent dengan biaya komputasi tinggi masih melewatkan sekitar sepertiga dari jawaban kunci (golden answers), menandakan bahwa teknologi agentic search masih memiliki ruang improvisasi yang luas.
- Fokus pada Akurasi & Kelengkapan: Mengevaluasi seberapa baik agent menemukan entitas dan memperkaya data dari berbagai sumber web.
- Metrik Row F1: Mengukur keberhasilan agent dalam menyelesaikan seluruh baris data dengan benar; tidak ada agent di bawah $1/tugas yang mencapai skor di atas 0.5.
- Pipeline Otomatis: ATLAS menggunakan sistem yang dapat diperbarui secara berkala seiring perkembangan web dan evolusi model AI.
- Temuan Utama: Search agents dengan komputasi maksimal konsisten mengungguli model yang lebih ringan, namun efisiensi biaya tetap menjadi tantangan besar.
Analisis DO-AI:
ATLAS mengonfirmasi bahwa bottleneck utama AI saat ini bukan lagi sekadar reasoning, melainkan retrieval precision pada data yang dinamis. Bagi arsitek sistem, ini adalah sinyal untuk berhenti mengandalkan zero-shot search sederhana. Implementasi agent yang tangguh memerlukan orkestrasi multi-step retrieval dan mekanisme verifikasi silang (cross-referencing) yang ketat. Investasi pada custom search API yang lebih terstruktur (seperti Exa) akan lebih berdampak pada performa agent dibandingkan sekadar melakukan fine-tuning pada model LLM-nya itu sendiri.
3. Quicksand: Sandbox QEMU dari Microsoft untuk AI Agents
Sorotan Berita:
Microsoft merilis Quicksand, sebuah API Python asinkron yang dirancang untuk meluncurkan, mengendalikan, dan melakukan snapshotting pada virtual machines (VM) QEMU dengan fokus utama pada sandboxing AI agents. Quicksand memungkinkan pengembang untuk menjalankan kode yang dihasilkan oleh AI dalam lingkungan yang terisolasi secara aman tanpa memerlukan hak akses root atau ketergantungan pada Docker. Alat ini mendukung distro Linux populer seperti Ubuntu dan Alpine, serta kompatibel dengan arsitektur x86_64 dan ARM64 di berbagai sistem operasi utama.
- Isolasi Tanpa Root: Menjalankan sandbox dengan keamanan tinggi tanpa perlu privilege administratif atau daemon Docker.
- Snapshotting & State Management: Memungkinkan pengambilan snapshot VM untuk memulihkan keadaan lingkungan dengan cepat setelah eksekusi kode oleh agent.
- Konfigurasi Jaringan Fleksibel: Mendukung isolasi jaringan total secara default, dengan opsi port forwarding dan akses internet jika diperlukan.
- Multi-User Support: Kemampuan untuk memberikan akun pengguna Linux independen bagi beberapa agent dalam satu VM sandbox yang sama.
Analisis DO-AI:
Quicksand adalah infrastruktur krusial bagi era Agentic Workflows di mana AI diberikan kemampuan code execution. Menggunakan Docker untuk sandboxing kode yang tidak terpercaya (untrusted code) sering kali memiliki celah keamanan pada level kernel sharing. Dengan beralih ke QEMU via Quicksand, kita mendapatkan isolasi level hypervisor yang jauh lebih kuat dengan overhead yang tetap terkendali. Fitur snapshotting-nya sangat vital untuk debugging dan rollback ketika agent melakukan kesalahan fatal pada sistem file virtual.
Matriks Perbandingan Eksekutif Pagi Ini
| Dispatch |
Core Domain |
Production Maturity |
DO-AI Recommendation |
| Speculative Decoding |
Inference Optimization |
High (Ready for Scale) |
Implementasikan untuk menekan latensi pada low-batch user apps. |
| ATLAS Benchmark |
Agent Evaluation |
Beta (Emerging Standard) |
Gunakan sebagai standar evaluasi internal untuk RAG-based agents. |
| Quicksand (MSFT) |
AI Safety & Security |
Early Production |
Gantikan Docker dengan Quicksand untuk agent code execution yang lebih aman. |