
Panduan Arsitektur: Designing Idempotent Event Pipelines: Outbox Pattern vs — Bagaimana Menerapkannya Secara Efisien?
Ringkasan: Dual-write anomaly adalah pembunuh diam-diam dalam arsitektur microservices. Untuk menjamin konsistensi data tanpa mengorbankan ketersediaan melalui Two-Phase Commit (2PC), kita harus memisahkan proses database commit dari message publishing menggunakan Transactional Outbox pattern, dan pada akhirnya menskalakan pipeline tersebut melalui Change Data Capture (CDC) yang dipadukan dengan idempotent consumers.
Tahun 2026 membawa kita pada era di mana ekspektasi pengguna terhadap kecepatan dan keandalan sistem berada pada titik tertinggi sepanjang masa. Sebagai software architect, saya sering kali dihadapkan pada satu pertanyaan fundamental yang terus berulang di setiap sesi whiteboarding: "Bagaimana kita memastikan bahwa ketika seorang pengguna menekan tombol Checkout, uang mereka terpotong di database DAN pesanan mereka benar-benar dikirim ke sistem gudang?"
Kedengarannya seperti masalah sepele. Di era monolitik, kita hanya perlu membungkus kedua operasi tersebut dalam satu transaksi database. Namun, di dunia microservices yang terdistribusi, di mana database dan message broker (seperti Kafka, RabbitMQ, atau Google Cloud Pub/Sub) hidup di cluster yang berbeda, dipisahkan oleh jaringan yang rapuh, masalah sepele ini berubah menjadi mimpi buruk operasional.
Dalam esai ini, saya ingin mengajak Anda menyelami anatomi dari kegagalan sistem terdistribusi, mengapa pola pikir sinkron tidak lagi relevan, dan bagaimana kita bisa merancang event pipeline yang idempotent dan tahan banting menggunakan kombinasi Outbox Pattern dan Change Data Capture (CDC).
Tragedi di Balik Baris Kode yang Terlihat "Aman"
Mari kita mulai dengan sebuah skenario yang mungkin pernah Anda tulis atau review di masa lalu. Anda sedang membangun Order Service. Logika bisnisnya sederhana: simpan pesanan ke database, lalu publikasikan event OrderCreated ke message broker agar Inventory Service bisa mengurangi stok barang.
Kode Anda mungkin terlihat seperti ini:
func CreateOrder(order Order) error {
    // 1. Simpan ke Database
    if err := db.Save(&order).Error; err != nil {
        return err
    }

    // 2. Publikasikan Event ke Message Broker
    event := map[string]interface{}{"order_id": order.ID, "status": "CREATED"}
    if err := messageBroker.Publish("orders_topic", event); err != nil {
        return err
    }

    return nil
}
Secara kasat mata, kode di atas terlihat masuk akal. Make sense, kan? Namun, di lingkungan produksi yang berskala besar, kode ini adalah sebuah bom waktu yang menunggu untuk meledak. Kita menyebutnya sebagai Dual-Write Problem.
Mari kita bedah apa yang terjadi ketika hukum fisika dan jaringan mulai ikut campur:
Skenario Kegagalan 1: Database Sukses, Broker Gagal
Langkah pertama (db.Save) berhasil. Pesanan tersimpan di database. Namun, tepat sebelum langkah kedua dieksekusi, terjadi network blip (misalnya, BGP route flapping di data center atau pod Kafka sedang melakukan leader election). Fungsi Publish mengembalikan error.
Apa dampaknya? Pengguna melihat pesanan mereka berhasil dibuat (dan mungkin kartu kredit mereka sudah di- charge), tetapi Inventory Service tidak pernah menerima event tersebut. Barang tidak pernah dikemas. Pelanggan marah. Anda harus melakukan rekonsiliasi data manual di tengah malam.
Skenario Kegagalan 2: Broker Sukses, Database Gagal "Ah, kalau begitu kita balik saja urutannya!" pikir seorang engineer junior.
    // 1. Publikasikan Event
    messageBroker.Publish("orders_topic", event)
    // 2. Simpan ke Database
    db.Save(&order)
Sekarang, event berhasil dipublikasikan ke Kafka. Inventory Service langsung memotong stok dan memerintahkan gudang untuk mengirim barang. Namun, saat mencoba menyimpan ke database, terjadi constraint violation (misalnya, ID pengguna tidak valid) atau database sedang mengalami deadlock. Transaksi database gagal. Dampaknya jauh lebih parah: Gudang mengirimkan barang bernilai jutaan rupiah untuk pesanan yang secara teknis tidak pernah ada di sistem kita. Ini adalah kerugian finansial langsung bagi perusahaan.
Ilusi bahwa kita bisa melakukan dua operasi I/O ke dua sistem terdistribusi yang berbeda secara atomik tanpa mekanisme khusus adalah salah satu kesalahan paling mahal dalam rekayasa perangkat lunak.
Mengapa Two-Phase Commit (2PC) Adalah Relikui Masa Lalu
Secara historis, industri perangkat lunak mencoba memecahkan masalah ini menggunakan Distributed Transactions, khususnya protokol Two-Phase Commit (2PC) atau XA Transactions.
Dalam 2PC, sebuah Transaction Coordinator akan memimpin tarian antara database dan message broker.
- Fase Prepare: Koordinator bertanya kepada database dan broker, "Apakah kalian berdua siap untuk commit?" Keduanya mengunci resource mereka dan menjawab "Ya".
- Fase Commit: Koordinator kemudian berkata, "Bagus, sekarang commit!"
Kedengarannya sempurna, bukan? Sayangnya, di arsitektur cloud-native modern tahun 2026, 2PC pada dasarnya sudah mati. Ada beberapa alasan fundamental mengapa kita tidak lagi menggunakannya:
Pertama, kinerja dan ketersediaan. 2PC adalah protokol yang blocking. Selama fase prepare, database harus menahan lock pada baris data. Jika message broker merespons dengan lambat, database akan tertahan, menyebabkan connection pool exhaustion dan menurunkan throughput sistem secara drastis. Berdasarkan Teorema CAP, 2PC mengorbankan Availability demi Consistency. Di dunia e-commerce atau fintech, sistem yang lambat atau down sama buruknya dengan sistem yang salah.
Kedua, dukungan teknologi. Sebagian besar message broker modern yang dirancang untuk high-throughput (seperti Apache Kafka, Amazon Kinesis, atau Google Cloud Pub/Sub) secara eksplisit tidak mendukung transaksi XA/2PC. Mereka dirancang untuk kecepatan dan partisi data, bukan untuk berpartisipasi dalam transaksi terdistribusi yang lambat.
Ketiga, seperti yang dijelaskan dengan sangat baik oleh Chris Richardson dalam referensi arsitektur fundamentalnya di Microservices.io mengenai Transactional Outbox, sangat tidak diinginkan untuk mengawinkan (couple) sebuah service secara erat dengan database dan message broker sekaligus dalam satu siklus transaksi. Ketergantungan ini membuat sistem menjadi rapuh dan sulit untuk di-scale secara independen.
Jika 2PC bukan pilihan, lalu bagaimana kita bisa memperbarui database dan mengirim pesan ke broker secara atomik?
Membedah Anatomi Transactional Outbox Pattern
Jawaban atas dilema dual-write ini adalah mengubah paradigma kita dari "menulis ke dua tempat sekaligus" menjadi "menulis ke satu tempat, dan membiarkan proses lain mengurus sisanya". Inilah esensi dari Transactional Outbox Pattern.
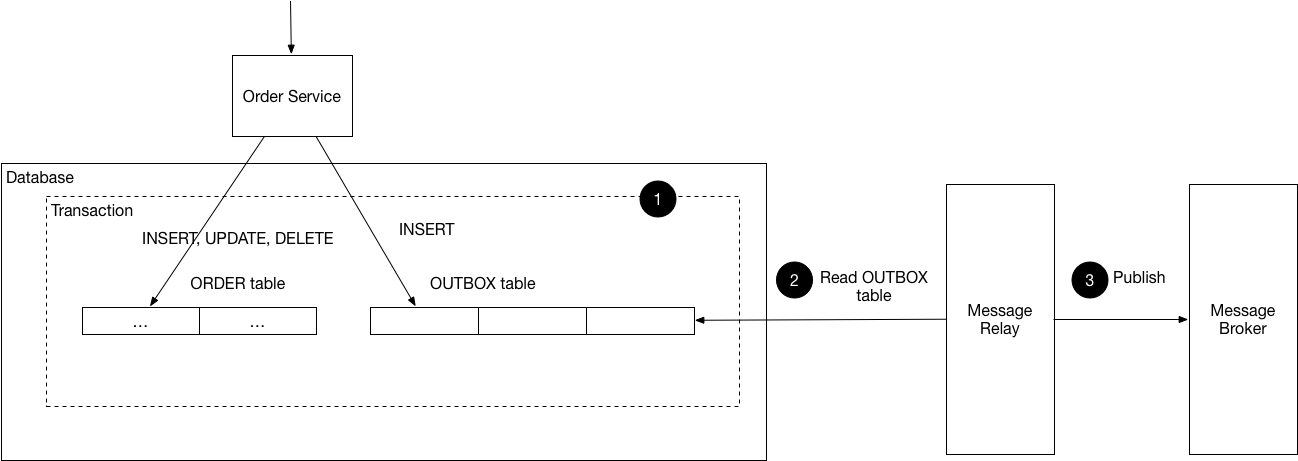
Alih-alih mencoba mengirim pesan langsung ke broker saat pengguna melakukan checkout, kita menyimpan pesan tersebut ke dalam sebuah tabel khusus di database yang sama dengan data bisnis kita. Tabel ini bertindak sebagai "kotak keluar" (outbox).
Karena tabel data bisnis (misalnya orders) dan tabel outbox berada di dalam database relasional yang sama, kita bisa memanfaatkan transaksi ACID lokal (yang sangat cepat dan andal) untuk menjamin atomisitas.
Mari kita lihat skema tabel outbox yang ideal:
CREATE TABLE outbox_events (
    id UUID PRIMARY KEY,
    aggregate_type VARCHAR(255) NOT NULL, -- e.g., 'Order'
    aggregate_id VARCHAR(255) NOT NULL,   -- e.g., 'ORD-123'
    event_type VARCHAR(255) NOT NULL,     -- e.g., 'OrderCreated'
    payload JSONB NOT NULL,               -- The actual message data
    created_at TIMESTAMP WITH TIME ZONE DEFAULT NOW(),
    processed BOOLEAN DEFAULT FALSE       -- Used if polling
);
Dengan pola ini, logika aplikasi kita berubah menjadi:
- Mulai transaksi database lokal (
BEGIN). - Simpan pesanan ke tabel
orders. - Simpan event
OrderCreatedke tabeloutbox_events. - Commit transaksi (
COMMIT).
Jika transaksi berhasil, kita memiliki jaminan matematis 100% bahwa pesanan tersimpan DAN pesan siap untuk dikirim. Jika transaksi gagal (misalnya karena constraint), keduanya dibatalkan (rollback). Tidak ada lagi ghost orders. Tidak ada lagi pesanan yang tidak terkirim.
Namun, pola ini memunculkan satu pertanyaan kritis baru: Bagaimana cara kita memindahkan data dari tabel outbox_events ke message broker secara real-time?
Di sinilah perjalanan arsitektur kita menjadi sedikit lebih rumit. Menurut literatur Microservices.io, ada dua pola utama untuk mengimplementasikan komponen Message Relay ini: Polling Publisher dan Transaction Log Tailing.
Polling vs Change Data Capture (CDC): Memilih Racun Anda
Memilih cara untuk mengekstraksi data dari outbox adalah salah satu keputusan arsitektur paling krusial yang akan Anda buat. Masing-masing memiliki trade-off yang signifikan dari segi kompleksitas operasional, latensi, dan biaya infrastruktur.
Pendekatan 1: The Polling Publisher (Mudah di Awal, Menderita di Akhir)
Pendekatan paling intuitif adalah membuat sebuah background worker (misalnya cron job atau goroutine yang berjalan terus-menerus) yang melakukan query ke database setiap detik:
SELECT * FROM outbox_events WHERE processed = false ORDER BY created_at ASC LIMIT 100;
Worker ini akan mengambil pesan, mempublikasikannya ke Kafka, lalu menandainya sebagai selesai:
UPDATE outbox_events SET processed = true WHERE id IN (...);
Kelebihan: Sangat mudah diimplementasikan. Anda tidak memerlukan infrastruktur tambahan. Cukup tulis beberapa baris kode di aplikasi Anda, dan sistem berjalan.
Kekurangan: Pendekatan ini adalah pembunuh database secara perlahan. Bayangkan Anda memiliki 10 instance microservice yang masing-masing melakukan polling setiap detik. Itu berarti 864.000 query per hari hanya untuk bertanya, "Apakah ada pesan baru?".
Lebih buruk lagi, di database dengan arsitektur Multi-Version Concurrency Control (MVCC) seperti PostgreSQL, operasi UPDATE processed = true yang terus-menerus akan menciptakan dead tuples dalam jumlah masif. Proses autovacuum PostgreSQL akan bekerja keras, memakan CPU dan I/O disk, yang pada akhirnya akan memperlambat query bisnis utama Anda. Latensi pengiriman pesan juga dibatasi oleh interval polling Anda.
Pendekatan 2: Transaction Log Tailing / CDC (Kompleks, Tapi Skalabel)
Untuk sistem berskala besar di tahun 2026, Polling tidak lagi dapat diterima. Solusi modernnya adalah Change Data Capture (CDC) melalui Transaction Log Tailing.
Setiap database relasional modern memiliki log internal yang mencatat setiap perubahan data sebelum ditulis ke disk. Di PostgreSQL, ini disebut Write-Ahead Log (WAL). Di MySQL, ini disebut Binlog.
Alih-alih melakukan query SELECT ke tabel, kita menggunakan tool CDC (seperti Debezium, Google Cloud Datastream, atau AWS DMS) yang bertindak seolah-olah ia adalah database replica. Tool ini membaca WAL secara streaming dan asinkron, mendeteksi setiap operasi INSERT ke tabel outbox_events, dan langsung mempublikasikannya ke Kafka atau Pub/Sub.
Kelebihan:
- Zero Impact pada Database: Karena CDC membaca langsung dari log biner di level file system (atau melalui logical replication slot), tidak ada query overhead yang membebani engine database.
- Real-time: Latensi pengiriman pesan turun dari hitungan detik (pada polling) menjadi milidetik.
- Skalabilitas: Mampu menangani ribuan event per detik tanpa berkeringat.
Kekurangan: Kompleksitas infrastruktur. Anda sekarang harus mengelola cluster Kafka Connect, memantau replication lag, dan menangani evolusi skema. Ini bukan untuk tim yang lemah jantung.
Namun, mari kita lihat dampak nyatanya dari kacamata FinOps dan Total Cost of Ownership (TCO). Seringkali, engineer menghindari CDC karena dianggap "terlalu mahal untuk di-setup". Mari kita buktikan dengan simulasi matematis yang deterministik.