Inilah kisah horor finansial yang dialami oleh hampir setiap enterprise yang mengadopsi teknologi AI: kuburan GPU yang menganggur (the idle GPU graveyard).
Untuk menjalankan pipeline embedding vektor khusus, layanan segmentasi gambar, atau reranker open-source, tim rekayasa biasanya men-deploy node pool khusus di Google Kubernetes Engine (GKE) atau Compute Engine. Mereka mem-provision instance GPU NVIDIA L4 atau A100 demi menjamin respon sub-detik yang cepat.
Lalu traffic pengguna mereda pukul 19:00 malam. Sepanjang malam dan akhir pekan, node-node GPU tersebut berjalan pada utilisasi 1%, diam-diam membakar ratusan dolar anggaran perusahaan hanya demi menunggu satu request HTTP acak yang masuk.
Menyewa cluster GPU khusus untuk microservices yang sifatnya bursty ibarat menyewa penthouse mewah seharga $15.000 per bulan sepanjang tahun hanya untuk tidur dua jam di Sabtu malam. Yang sebenarnya dibutuhkan oleh tim engineer adalah kamar hotel butik yang menagih biaya per menit saat kartu kunci terpasang di pintu, dan menagih tepat $0.00 saat kamar kosong melompong.
Dengan ketersediaan umum Dukungan GPU Native di Google Cloud Run, nilai ekonomis kontainer serverless akhirnya tiba untuk komputasi terakselerasi GPU.
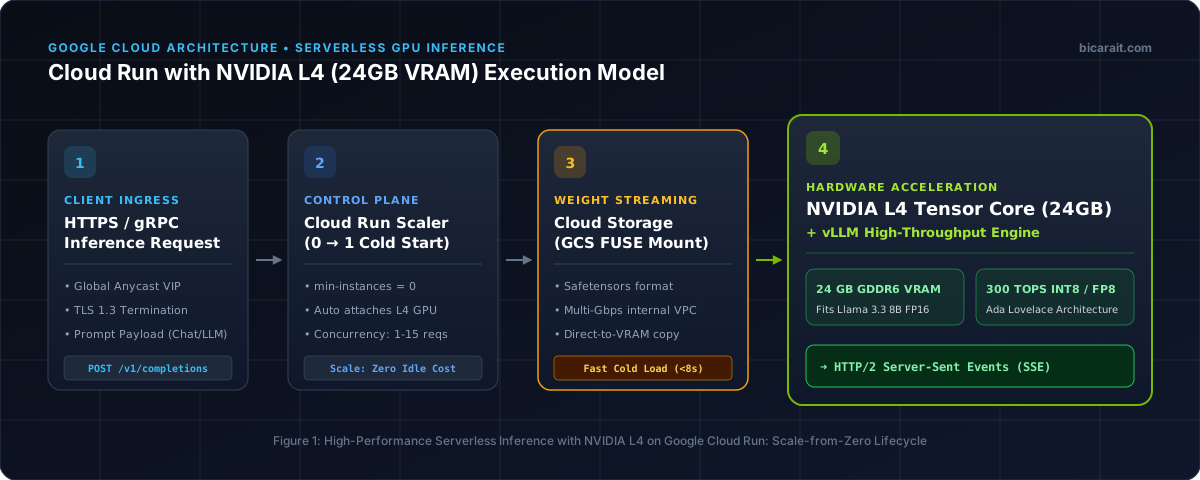 Gambar 1: Arsitektur Scale-from-Zero dan Siklus Streaming Bobot Model Menggunakan GPU NVIDIA L4 di Cloud Run.
💡 Cetak Biru Eksekutif (TL;DR)
💡 Cetak Biru Eksekutif (TL;DR)
Google Cloud Run dengan Dukungan GPU Native memungkinkan tim men-deploy beban kerja AI berbasis kontainer pada GPU NVIDIA L4 dengan kemampuan otomatis scale-to-zero. Dengan menagih biaya murni per-milidetik saat request sedang diproses dan melakukan streaming layer kontainer dari Artifact Registry, Cloud Run mengeliminasi pengeluaran GPU yang menganggur tanpa membutuhkan operasi manajemen cluster Kubernetes yang rumit.
┌─────────────────────────────────────────────────────────────────────────────┐
│                 GKE DEDICATED vs. SERVERLESS CLOUD RUN GPU                  │
├─────────────────────────────────────────────────────────────────────────────┤
│ Node Pool GPU GKE Khusus (Selalu Menyala, Biaya Dasar Tinggi):              │
│ [Sen-Jum: Beban Tinggi] [Sab-Min: Nol Beban (Tetap Ditagih $450/bln per GPU)│
├─────────────────────────────────────────────────────────────────────────────┤
│ GPU Native Google Cloud Run (Scale-to-Zero, Tagihan Utilitas Sejati):       │
│ [Request Aktif ➔ 1 Instance Ditagih] ➔ [Nol Traffic ➔ 0 Instance Billed $0]│
│ 💰 Hasil: Penghematan Biaya Infrastruktur Hingga 70% untuk AI Service Bursty│
└─────────────────────────────────────────────────────────────────────────────┘
📊 Matriks Perbandingan Arsitektur Serving AI
| Faktor Arsitektur |
Cluster GPU GKE Khusus |
Pool VM Compute Engine |
Cloud Run GPU Native |
| Denda Biaya Idle |
Tinggi: Ditagih 24/7 tanpa melihat beban |
Tinggi: Ditagih terus-menerus |
Nol: Ditagih murni per milidetik request |
| Pemeliharaan Cluster |
Upgrade OS node & patch Kubernetes |
Patch OS image & konfigurasi systemd |
Nol: Lingkungan serverless terkelola 100% |
| Mitigasi Cold Start |
Instan (node selalu dalam keadaan hangat) |
Lambat (overhead booting VM) |
Optimal: Streaming image Artifact Registry |
| Target Hardware |
Katalog Lengkap Nvidia (H100, A100, L4) |
Katalog Lengkap Nvidia |
NVIDIA L4 (24GB VRAM) |
| Mekanisme Autoscaling |
Cluster Autoscaler (jeda 2–5 menit) |
Instance Groups (jeda 3–6 menit) |
Skalabilitas Konkurensi Cepat (Detik) |
🔬 Blueprint Arsitektur 1: Cara Kerja Scale-to-Zero pada Bobot Model Raksasa
Hambatan teknis historis yang sebelumnya menghalangi kontainer GPU serverless adalah ukuran image.
Image kontainer yang menggabungkan PyTorch, runtime driver CUDA, dan bobot checkpoint model berparameter 7 miliar dapat dengan mudah membengkak hingga ukuran 15GB sampai 25GB. Menarik layer sebesar 20GB melalui jaringan saat cold start akan menimbulkan lonjakan latensi hingga 45 detik, menggugurkan esensi dari serverless.
Google Cloud Run mengatasi kendala ini melalui dua integrasi infrastruktur mendalam:
- Streaming Kontainer Regional: Cloud Run terintegrasi dengan Artifact Registry untuk melakukan streaming blok image secara on-demand. Kontainer mulai menginisialisasi kernel CUDA sebelum seluruh image 20GB selesai diunduh secara penuh.
- Persistent Fast Disk Caching: Dengan memasang Cloud Storage FUSE atau Google Cloud Hyperdisk regional, bobot model dapat dipetakan secara memory-map ke dalam VRAM GPU hanya dalam hitungan detik.
🔬 Blueprint Arsitektur 2: Spesifikasi Service Tingkat Production
Men-deploy microservice HuggingFace embedding yang teroptimasi pada GPU NVIDIA L4 tidak memerlukan manifes Kubernetes yang rumit—cukup definisi service Knative yang bersih dan deklaratif:
apiVersion: serving.knative.dev/v1
kind: Service
metadata:
  name: semantic-embed-service
  annotations:
    run.googleapis.com/ingress: internal-and-cloud-load-balancing
spec:
  template:
    metadata:
      annotations:
        # Minta akselerasi GPU NVIDIA L4 khusus
        run.googleapis.com/gpu-type: nvidia-l4
        run.googleapis.com/gpu-count: "1"
        # Terapkan scale-to-zero jika menganggur selama 60 detik
        autoscaling.knative.dev/minScale: "0"
        autoscaling.knative.dev/maxScale: "10"
    spec:
      containerConcurrency: 4 # Request konkuren per instance GPU
      containers:
        - image: us-central1-docker.pkg.dev/my-retail-prod/ai-repo/bge-reranker:latest
          resources:
            limits:
              cpu: "4"
              memory: "16Gi"
          env:
            - name: MODEL_NAME
              value: "BAAI/bge-reranker-large"
            - name: TORCH_DEVICE
              value: "cuda"
🎯 Kesimpulan Editorial
Jika aplikasi Anda melayani inferensi bervolume tinggi tanpa henti 24/7 yang melampaui 1.000 query per detik, cluster GKE padat dengan vLLM tetap menjadi pilihan arsitektur paling efisien dari segi biaya.
Namun, untuk mayoritas beban kerja AI enterprise (the long tail)—seperti proses penyerapan dokumen batch, perangkuman laporan berkala tengah malam, transkripsi suara on-demand, atau tools AI internal karyawan—Cloud Run GPU adalah pengubah peta permainan yang sesungguhnya.
Teknologi ini melenyapkan biaya idle dalam semalam dan membebaskan bandwidth para senior engineer dari kerumitan mengelola node pool Kubernetes.
Use Case Nyata di Lapangan: Ide Implementasi Praktis
Di DO-AI, kami melihat bahwa hambatan utama adopsi AI bukanlah pada logika modelnya, melainkan pada biaya tinggi untuk menjaga hardware khusus tetap menyala. Dukungan GPU Native di Cloud Run mengubah ekonomi unit AI, memungkinkan tim men-deploy model performa tinggi semudah API web biasa. Berikut adalah tiga cara implementasinya saat ini:
1. Intelijen Dokumen Hukum & Kepatuhan On-Demand
- Masalah Sehari-hari di Lapangan: Tim legal seringkali perlu memproses 5.000 kontrak untuk audit tertentu sebulan sekali. Mempertahankan cluster GPU khusus untuk lonjakan sporadis ini mengakibatkan pemborosan biaya infrastruktur selama 29 hari.
- Cara Kerja Implementasinya: Deploy microservice pemrosesan dokumen (misal: LayoutLM atau Llama-3 yang terkuantisasi) di Cloud Run dengan GPU NVIDIA L4. Service tetap di angka nol instance hingga audit dimulai, lalu melakukan scaling ke 10+ GPU konkuren untuk memproses batch tersebut, dan langsung mati setelah selesai.
- Dampak Nyata pada Bisnis & Sistem: Mengurangi biaya overhead infrastruktur bulanan hingga 85% dibandingkan dengan node pool GKE berukuran tetap, sambil tetap mempertahankan kecepatan inferensi sub-detik.
2. Pencarian Visual & Rekomendasi E-commerce
- Masalah Sehari-hari di Lapangan: Retailer ingin menawarkan fitur "Cari dengan Gambar," tetapi traffic sangat fluktuatif—memuncak saat jam makan siang dan turun drastis ke nol pada jam 3 pagi. Embedding berbasis CPU terlalu lambat, dan GPU khusus terlalu mahal untuk jam-jam sepi.
- Cara Kerja Implementasinya: Gunakan model CLIP (Contrastive Language-Image Pre-training) yang dikontainerisasi di Cloud Run GPU. Saat pengguna mengunggah foto, Cloud Run menjalankan instance L4 untuk menghasilkan vector embedding dalam hitungan milidetik.
- Dampak Nyata pada Bisnis & Sistem: Memberikan pengalaman pengguna premium dengan latensi rendah tanpa "pajak idle" karena menjalankan GPU selama periode traffic rendah.
3. Transkripsi & Terjemahan Media Otomatis
- Masalah Sehari-hari di Lapangan: Platform konten perlu menghasilkan subtitle untuk video yang diunggah pengguna. Menggunakan fungsi serverless khusus CPU menyebabkan timeout untuk video panjang, sementara VM GPU khusus memerlukan manajemen antrean pekerjaan yang rumit.
- Cara Kerja Implementasinya: Implementasikan model Whisper dari OpenAI di Cloud Run GPU. Sistem memicu eksekusi kontainer setiap kali ada file baru masuk ke Cloud Storage. Akselerasi GPU memastikan video berdurasi 30 menit sekalipun dapat ditranskripsi dalam waktu singkat.
- Dampak Nyata pada Bisnis & Sistem: Waktu publikasi yang lebih cepat bagi kreator dan penyederhanaan arsitektur dengan menghapus kebutuhan akan logika autoscaling pod Kubernetes yang kompleks.